AI研究者?OmniScientistに「科学的発見」をさせてみたら、意外な結果になった

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

OmniScientistとは

OmniScientistは、AIが研究者のように仮説を立て、実験し、結果を検証するための研究エージェントです。

必要に応じて仮説を修正しながら、研究プロセスを自動で進めます。
最終的には、分析結果をまとめて**論文やPDFまで作成できる**のが特徴です。

そう、AIに論文を書かせることは、もうそれほど珍しくなくなってきました。

では、その一歩先――。

AI自身にデータを渡し、そこから未知の法則を発見させることはできるのでしょうか。

今回の前実験では、OmniScientistが実際に研究フローを最後まで走り、PDF論文まで作れることを確認できました。

そこで今回は、もう少し踏み込んでみました。

本当にデータの中に隠された法則を、自力で見つけられるのか。

これを試してみます。

OmniScientist用に架空のデータを作る

今回のために、5系列・合計900件の人工データを作りました。

これは、乱流のエネルギースペクトルをモチーフにした人工データです。

もう少し具体的にいうと、流体の乱れを「大きな渦から小さな渦へエネルギーが移っていく」ときのスペクトル形状をイメージして作っています。

ただしOmniScientistには、データが何を意味するのか一切教えません。

列名も、

run_id
x
y
sigma

だけです。

「これは流体のデータです」とも、「乱流を調べてください」とも言いません。

もちろん、「−5/3という指数を探せ」といったヒントもありません。

一方、データを作った側には答えがあります。

今回、裏側に仕込んだ式は次のようなものです。

y=A(x^4+x_0^4)^{-5/12}\exp[-(x/x_d)^{4/3}]

この式の面白いところは、データの場所によって振る舞いが変わることです。

低いxでは比較的なだらか。中間では、あるべき乗則が現れます。そして高いxでは急速な減衰が加わります。

特に中間領域には、

y\propto x^{-5/3}

という関係を隠してあります。

しかも、単純なモデルをデータ全体に当てはめても、見た目にはかなりよく合います。

つまり、「だいたい合っているからこれでいい」と止まってしまうと、本当の構造にはたどり着けません。

あえて少しわかりづらい問題にしました。

OmniScientistは12ページの論文まで完成させた

この匿名データをGPT-5.6 Solを使ったOmniScientistへ渡しました。

正解は完全に隠した状態です。

研究は1回だけ。途中でこちらからヒントを出すこともしません。

OmniScientistはデータを分析し、仮説を作り、実験を進め、Gateと呼ばれる評価工程も通過しました。

そして最後には、12ページのPDF論文まで完成させました。

ここだけを見ると、かなり順調です。

ところが、研究内容を見ると少し様子が違いました。

OmniScientistが選んだのは、本来隠していた式ではなく、

log-log空間の3次曲線+runごとの補正

というモデルでした。

さらに、モデルとデータのズレが予想より大きかったため、

「データに付けられているsigma、つまり測定誤差の見積もりが小さすぎるのではないか」

という結論を出しました。

この段階では正解をまだ見ていません。

そこでOmniScientistの結論と論文をすべて固定し、その後に初めて答え合わせをしました。

答えを開けてみると、重要な法則は見つかっていなかった

Ground Truth、つまりこちらが用意していた本当の答えと比較してみます。

結果はかなりはっきりしていました。

OmniScientistは、中間領域に隠した −5/3則を発見していませんでした。

指数そのものも推定できていません。

低x、中間、高xという複数の領域構造も明確には捉えておらず、高x側に仕込んでいた追加の減衰も見逃していました。

さらに興味深かったのが、先ほどのsigmaです。

OmniScientistは「測定誤差が小さすぎる」と考えました。

しかし、本当の生成式を使って残差を計算すると、sigmaはほぼ正しく設定されていました。

つまり実際には、

測定誤差がおかしかったのではなく、OmniScientist自身が選んだモデルが本当の曲線を十分に表現できていなかった

ということです。

モデルの間違いを、測定誤差の問題だと解釈してしまったわけです。

独自の採点基準では、Discovery Scoreは 28/100。

論文の信頼性を評価したPaper Reliability Scoreは 55/100。

評価は「限定的な部分発見」という結果になりました。」

GPT-5.6 Solを直接使ったらどうなるのか

ここで別の疑問が出てきます。

OmniScientistが見つけられなかったのは、エージェントの問題なのでしょうか。

それとも、そもそもGPT-5.6 Solにとって難しい問題だったのでしょうか。

そこで今度はOmniScientistを外し、GPT-5.6 Solへ同じ900件のデータを直接渡してみました。

新しい独立したAPI呼び出しです。

過去の実験結果も、Ground Truthも渡していません。

そしてAPI callはたった1回。

すると、面白い違いが出ました。

Direct Solも−5/3則そのものは発見できませんでした。

しかし、

「データ全体を1つの式では説明できない」

「低いxには別の肩のような構造がある」

「高いxには別の減衰構造がある」

「各runは単純な定数倍ではない」

といった点には気づきました。

つまり正解そのものには届いていないものの、データの構造にはOmniScientistより近づいたのです。

高x側については誤った関数形を提案しているので、もちろん完全正解ではありません。

それでも同じ採点基準を使うと、

OmniScientist:28/100
Direct Sol:56/100

となりました。

AIエージェントは、LLMを自動的に賢くするわけではない

さらに興味深いのが計算量です。

OmniScientistは研究に47回のAPI callを使い、約24万トークン、費用は約2.24ドル。

Direct Solは1回だけで、約3.4万トークン、約0.23ドルでした。

それでも今回の問題ではDirect Solの方が良い結果を出しました。

もちろん、これだけで「Direct Solの方がOmniScientistより優秀」と結論することはできません。

今回試したのは1つの人工データだけですし、問題設計にもGPT-5.6 Solが関わっています。

ただ、一つはっきりしたことがあります。

AIエージェントを使えば、基盤LLMの科学的発見能力が自動的に高くなるわけではない。

OmniScientistが得意なのは、仮説を作り、実験し、結果をまとめ、論文まで作る「研究プロセスの自動化」です。

一方で、

「どんな仮説を思いつくか」

「データのどこに本質的な構造があると気づくか」

という部分は、やはり基盤となるLLMの能力に大きく依存します。

そして今回さらに分かったのは、エージェントの研究ループが、場合によってはLLMを正しい方向へ導くとは限らないということです。

OmniScientistは立派な12ページの論文を作りました。

しかし、そこに書かれた中心的な発見の一つは間違っていました。

一方、Direct Solは論文こそ書きませんでしたが、データの構造にはより近づいていました。

「論文を作れるAI」と「科学的な法則を発見できるAI」は同じではない。

今回の実験で一番印象に残ったのは、そこでした。

次に試したいこと

今回の実験では、OmniScientistが研究プロセスを最後まで自動化できることは確認できました。

一方で、「研究をたくさん回せば、そのぶん正しい法則に近づける」とは限らないことも分かりました。

では次に何を見るべきか。

一つは、別の種類の問題でも同じ傾向が出るのかです。

今回は乱流をモチーフにした人工データでしたが、電池劣化、材料特性、天文観測、需要予測など、まったく違うデータでも、

– Direct LLM
– LLM+AIエージェント

を同じ条件で比較すれば、今回の結果がたまたまだったのか、それともある程度一般的な傾向なのかが見えてきます。

もう一つは、OmniScientistそのものの中身を分解して試すことです。

たとえば、

「Backtrackingを増やしたらどうなるのか」

「Gateをもっと厳しくしたら誤った結論を止められるのか」

「一つのモデルに早く決め打ちせず、複数仮説を並行して残したらどうなるのか」

といった比較です。

今回の失敗は、OmniScientistという考え方そのものが悪いというより、どの段階で仮説を捨て、どの段階で研究を続けるかというエージェント設計に改善の余地があることを示しているようにも見えます。

そして最終的には、人工データではなく実データです。

人工データなら答えを用意できるので性能評価には向いていますが、本当に面白いのは、まだ誰も明確な式にしていない実測データからAIが何かを見つけられるかどうかです。

もちろん、その場合はGround Truthがありません。

だからこそ、

AIが新しい関係を提案する
↓
別データで再現する
↓
既存研究と照合する
↓
新しい予測を出す
↓
人間が検証する

という、より本物の科学研究に近い流れが必要になります。

今回の実験は、その入口です。

まとめ

OmniScientistは12ページの論文を作れました。

Direct Solは、それより少ない計算量でデータの構造に近づきました。

しかし、どちらも隠していた本当の法則までは発見できませんでした。

この結果を見ると、AIによる科学研究で本当に重要なのは、単に「エージェント化すること」でも「LLMを大きくすること」でもなさそうです。

強いLLMと、正しく疑い続けられる研究ループをどう組み合わせるか。

次に試したいのは、そこです。

AIが論文を書くところまでは、すでにかなり来ています。

その次の壁は、それっぽい説明を作ることではなく、本当に新しいものを見つけられるか。

今回の実験を続けるなら、次はそこをもう少し本気で確かめてみたいと思います。

****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************
Lean言語とは。AIでの数学の証明に使われ出した

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

いま注目のLeanを、ごく簡単な証明で使ってみる

最近、AIや数学の話題を追っていると「Lean(リーン)」という名前を目にする機会が増えてきました。

Leanは、簡単に言えば**数学の証明をコンピューターに厳密にチェックしてもらうためのプログラミング言語・定理証明支援系**です。

普通のプログラミング言語が「計算したり、アプリを動かしたりする」ために使われるのに対して、Leanでは「この数学的な主張は本当に正しいのか」を、コンピューターに確認させることができます。

今回は難しい数学には踏み込まず、Leanを初めて触る人向けに、ごくごく簡単な証明を実際に書いてみます。

いま注目される「Lean」って何?

Leanは以前から存在していた言語ですが、一般のプログラマーに広く使われてきた言語ではありません。

主に、形式証明や数学、コンピューター科学などの専門分野で使われてきました。

ところが最近は、AIに数学の問題を解かせる研究が活発になり、

AIが証明を考える
↓
Leanのコードに変換する
↓
Leanが本当に正しい証明かチェックする

という使い方が注目されています。

AIは非常に賢くなりましたが、それでも間違ったことを書く場合があります。

そこで、最終的なチェック役としてLeanを使うわけです。

AIが「たぶん正しい」と答えるだけではなく、Leanによって形式的に検証できれば、証明の信頼性を大きく高めることができます。

Leanは普通のプログラミング言語と何が違うのか

例えばPythonなら、

print(1 + 1)

と書けば、

2

と表示されます。

これは「1+1を計算してください」というプログラムです。

一方、Leanでは、

theorem one_plus_one : 1 + 1 = 2 := by
rfl

のように書くことができます。

※Leanのコードで表示のバグで、インテントがうまく表示されません。ご了承ください。

これは計算結果を表示しているのではなく、

「1 + 1 = 2という命題が正しいことを証明してください」

という意味です。

theorem は英語で「定理」という意味です。

そしてLeanが証明を最後まで確認し、問題がなければ、その定理が証明されたことになります。

まずは超簡単な証明を書いてみよう

今回は少しだけ証明らしい例を使ってみます。

証明したい内容はこちらです。

a + b + 0 = b + a

aとbには好きな自然数を入れることができます。

例えば、

3 + 5 + 0 = 5 + 3

なら、どちらも8です。

これをLeanで書くと次のようになります。

theorem simple_example (a b : Nat) :
a + b + 0 = b + a := by
rw [Nat.add_zero]
rw [Nat.add_comm]

証明部分はたった2行です。

「a + b + 0 = b + a」を2行で証明してみる

まず1行目です。

rw [Nat.add_zero]

Nat.add_zero は、

x + 0 = x

という、すでにLean側で証明されている事実です。

そのため、

a + b + 0

は、

a + b

に書き換えることができます。

ここで証明したい式は、

a + b = b + a

になります。

そこで次の行です。

rw [Nat.add_comm]

Nat.add_comm は足し算の交換法則です。

つまり、

a + b = b + a

が成り立つという、すでに証明済みの定理です。

これを使うと左右が完全に一致し、証明が終了します。

流れだけを見ると、

a + b + 0
↓
a + b
↓
b + a

となります。

かなり人間の数学の証明に近いことが分かります。

 Leanはどうやって「証明できた」と判断するのか

学校の数学なら、証明の最後に、

「よって、a + b + 0 = b + a である。」

あるいは、

Q.E.D.

などと書くことがあります。

Leanでは、こうした文章を書く必要はありません。

証明を進めていき、最後に「まだ証明しなければならない項目」がゼロになれば、その時点で証明完了です。

先ほどの例なら、

rw [Nat.add_comm]

を実行したところで左右が一致します。

そのためLeanにとっては、

「未証明のものはもうありません」

という状態になります。

これ自体が、数学でいう「証明終了」に相当します。

AI時代にLeanが注目されている理由

Leanの面白さは、単に人間が数学の証明を書くためだけの道具ではないところにあります。

AIとの組み合わせが非常に相性が良いのです。

例えばAIに難しい数学の問題を与え、

AIが証明方法を考える
↓
Leanのコードを書く
↓
Leanが検証
↓
失敗したらAIが修正
↓
もう一度Leanで検証

というループを作ることができます。

AIは仮説やアイデアを大量に作るのが得意です。

一方、Leanは「その証明が本当に正しいのか」を厳密にチェックするのが得意です。

つまり、

**AIが考える役、Leanが検証する役**

という役割分担ができます。

今回の、

theorem simple_example (a b : Nat) :
a + b + 0 = b + a := by
rw [Nat.add_zero]
rw [Nat.add_comm]

という例は非常に簡単ですが、基本的な考え方はもっと高度な数学でも同じです。

既に証明されている定理を使いながら、新しい証明を積み上げていきます。

Leanは少し前まではかなり専門的な世界で使われる印象の強いツールでした。

しかしAIが数学や科学研究に入り始めたことで、その存在感は以前より大きくなっています。

最初から難しい証明に挑戦する必要はありません。

まずは今回のような2行程度の証明から触ってみると、

「コンピューターに数学を証明させるとは、こういうことなのか」

という感覚がつかみやすいと思います。

巻末 これは何の問題でしょう

下記にLeanで何かの問題文を書いています。当ててください。
答えは最後にあります。

*表示のバグでインテントが崩れています。コピペしてお気に入りのLLMに直してもらってください。

import Mathlib/-!
Simplified Navier–Stokes blow-up problem
教育用の簡略化した問題文
-/– 時刻
abbrev Time := ℝ– 3次元空間
abbrev Space := ℝ × ℝ × ℝ– 速度場 u(x,t)
abbrev VelocityField :=
Space → Time → (ℝ × ℝ × ℝ)– 圧力 p(x,t)
abbrev PressureField :=
Space → Time → ℝ– 外力 f(x,t)
abbrev ForceField :=
Space → Time → (ℝ × ℝ × ℝ)

— u が滑らかである
axiom SmoothVelocity :
VelocityField → Prop

— f が滑らかである
axiom SmoothForce :
ForceField → Prop

— 非圧縮条件 div u = 0
axiom DivergenceFree :
VelocityField → Prop

— ⚪︎⚪︎方程式を満たす
axiom SatisfiesNavierStokes :
VelocityField →
PressureField →
ForceField →
Prop

— 初期状態 u(x,0) = 0
def InitiallyAtRest (u : VelocityField) : Prop :=
∀ x : Space,
u x 0 = (0, 0, 0)

— エネルギーが有限
axiom FiniteEnergy :
VelocityField → Prop

— 時刻 T で速度が発散する
axiom BlowsUpAt :
VelocityField →
Time →
Prop

/–
問題:

滑らかな外力 f を与えることで、
初期状態が静止している3次元非圧縮流体が
Navier–Stokes方程式に従いながら、
有限時間 T で特異点を形成する例が存在することを示せ。
-/
theorem simplified_navier_stokes_blowup :
∃ (u : VelocityField)
(p : PressureField)
(f : ForceField)
(T : Time),
T > 0 ∧
SmoothVelocity u ∧
SmoothForce f ∧
DivergenceFree u ∧
InitiallyAtRest u ∧
SatisfiesNavierStokes u p f ∧
FiniteEnergy u ∧
BlowsUpAt u T := by
sorry

— 答え:
— 3次元非圧縮 Navier–Stokes 方程式における
— 「有限時間での特異点(ブローアップ)の存在問題」を
— 教育用に簡略化して表現したものです。

もういっちょ、おまけに

import Mathlib/-!
Fermat’s Last Theorem
教育用の簡略化した問題文
-/– 自然数 n が 2 より大きい
def ExponentCondition (n : ℕ) : Prop :=
n > 2– a, b, c が正の自然数
def PositiveTriple (a b c : ℕ) : Prop :=
a > 0 ∧
b > 0 ∧
c > 0

— ⚪︎⚪︎型の方程式
def FermatEquation (a b c n : ℕ) : Prop :=
a ^ n + b ^ n = c ^ n

/–
問題:

自然数 n > 2 に対して、

a^n + b^n = c^n

を満たす正の自然数 a, b, c は
存在しないことを示せ。
-/
theorem fermat_last_theorem :
∀ n : ℕ,
ExponentCondition n →
¬ ∃ (a b c : ℕ),
PositiveTriple a b c ∧
FermatEquation a b c n := by
sorry

— 答え:
— フェルマーの最終定理
—
— n > 2 の整数 n に対して、
— a^n + b^n = c^n
— を満たす正の整数 a, b, c は存在しない、
— という定理を教育用に簡略化して表現したものです。


****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

起業家を応援する、Startup Builder Liteアプリを公開しました

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

起業家を応援する、Startup Builder Liteとは?

Startup Builder Liteは、起業アイデアをAIと一緒に整理しながら、少しずつ事業の形にしていくためのWebツールです。

「Startup Builder Lite」はこちら。←只今、調整中です。

※ APIを使っているので、利用者が多い場合は、利用制限かかかる場合があります。
その際は数日で利用制限が解除されますので、しばらくたってからご利用ください。

起業してみたい気持ちはあるものの、「何から始めればいいのか分からない」「事業計画書なんて難しそう」と感じる起業初心者でも使いやすいように、画面の案内に沿って進められる構成にしています。

AIに相談しながら考えを整理し、その内容を事業プロフィールや事業計画、市場分析などへつなげていけるのが特徴です。

起業初心者でも進めやすいように作った理由

起業準備では、専門用語や数字、事業計画、市場調査など、最初から難しく感じる項目が多くあります。

そこでStartup Builder Liteでは、「全部を最初から理解していなくても進められる」ことを重視しました。

分からない項目は空欄でも進められるようにしたり、入力例や説明を表示したり、AIが文章作成を補助したりすることで、起業初心者が途中で止まりにくい設計を目指しています。

Startup Builder Liteでできること

Startup Builder Liteでは、AIへの起業相談から始まり、事業プロフィールの作成、事業計画書、市場・競合分析、MVP仕様、収支シミュレーション、AI利用コスト試算、KPI管理、営業資料作成、専門家視点のAI相談まで利用できます。

一つの機能だけを使うのではなく、起業準備を順番に進めていけるよう、ダッシュボード上で現在の進行状況も確認できます。

起業初心者向けに工夫したポイント

特に重視したのが、「次に何をすればいいか分かること」です。

AI生成中には処理状況が分かるメッセージを表示し、生成後はその場ですぐ結果を確認できるようにしました。

また、AIを事業で使わない人はAIコスト試算をスキップでき、収支シミュレーションには専門用語の説明も追加しています。

専門家相談でも、「まずはこちらがおすすめ」と表示することで、誰に相談すればいいか迷いにくくしています。

Muse Sparkによる起業初心者UXテスト結果

完成版v0.3.2では、MetaのMuse Spark 1.2を使い、起業初心者を想定したUXテストを実施しました。

特に評価されたのは、AI生成後の結果表示、待ち時間の案内、ナビゲーション、AIコスト試算のスキップ機能などです。

表示エラーや重大な不具合もなく、起業初心者でも一連の流れをほぼ最後まで進められるという結果になりました。

まとめ

Startup Builder Liteは、起業の知識が少ない人でも、AIの支援を受けながら事業アイデアを具体化していけることを目標に開発。

まだ細かな改善余地はありますが、現時点でも起業相談から計画、市場分析、収支、営業資料まで一通り体験できる形になっています。

これからは実際の利用者の声も取り入れながら、さらに分かりやすく、使いやすいサービスへ改善していく予定です。

起業したい学生やサラリーマンの方など、ぜひこのアプリを使ってご自分の未来の事業に活かしてください。

****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************
Fable5に聞いてみた AIはアインシュタインの相対性理論を発見できるのか?

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

またまたFable5が公開されましたね。
やがて従量課金になるらしく、ここぞとばかり使いまくっている方も多いでしょう。

ちなみにFable5とはアンソロピック社が出しているLLMのフロンティアモデル(最上級モデル)のことです。

そこで、今回のテーマは前々から非常に興味のあった
AIはアインシュタインの相対性理論を発見できるのか?
これをFable5に聞いてみました。

巻末に回答を原文ママで載せておきます。数式バリバリです。
こりゃなんぞやかもです。

まあ、でもしっかりと方向性は示してくれました。
そう、AIはアインシュタインの相対性理論を自力では発見できない。
しかし、人間との共創で発見できる可能性はあると。

何とも勇気の出る言葉ではないでしょうか。

今現在、2026年7月初頭。この地球上で多分1番知識力のあるAIの回答です。

真摯に受け止め、ではAIと人類との共創で、まだ見ぬ未知の理論への発見へ。GOです。

AIは、アインシュタインのように相対性理論を発見できるのか?

最近のLLM、つまり大規模言語モデルの進化を見ていると、こんな疑問が出てきます。文章を書く、コードを書く、数式を説明する、論文を要約する。ここまでできるなら、もしかすると科学理論そのものも発見できるのではないか。

そこで今回は、Fable5に「LLMで相対性理論を発見できるのか?」というテーマで聞いてみました。

結論から言うと、Fable5の答えはかなり現実的でした。LLM単体で相対性理論を発見するのは難しい。しかし、LLMを仮説生成役として使い、SymPyやPython、Leanのような外部ツールで検証するなら、相対性理論を再構成する実験は十分に可能だ、という内容です。

これは単なる相対性理論の解説ではありません。AIを使って科学的な考察をどう進めるか、という話でもあります。

そもそも相対性理論は、何を変えた理論なのか

相対性理論が登場する前、物理学の基本にはニュートン力学がありました。ニュートン力学では、時間は宇宙のどこでも同じように流れ、空間は固定された舞台のようなものだと考えられていました。

つまり、誰が見ても時間は同じ。距離も同じ。速度は普通に足し算できる。これが当たり前の世界観でした。

ところが、光について考えると、この常識が揺らぎます。

マクスウェル方程式からは、光の速さが一定の値として出てきます。さらに、マイケルソン・モーリー実験では、当時考えられていた「エーテル」という光の媒質の存在を示す証拠が見つかりませんでした。

つまり、「光は何に対して一定の速度で進むのか?」という問題が出てきたわけです。

ここでアインシュタインは、かなり大胆な選択をします。

光の速さは、誰から見ても一定である。
そのかわり、時間と空間の方が観測者によって変わる。

これが特殊相対性理論の大きな転換点です。時間と空間は絶対的なものではなく、観測者の運動状態によって混ざり合う。これにより、時間の遅れ、長さの収縮、そして E=mc² という有名な関係式につながっていきます。

特殊相対論は「矛盾を解くパズル」に近い

Fable5の回答で面白かったのは、特殊相対論を「演繹パズル」に近いものとして見ている点です。

特殊相対論の出発点は、ざっくり言えば矛盾です。

ニュートン力学では、速度は足し算できます。たとえば、電車の中で前にボールを投げれば、地上から見たボールの速度は「電車の速度+ボールの速度」になります。

ところが光で同じことを考えると、うまくいきません。光の速度が誰から見ても同じなら、普通の速度の足し算では説明できないからです。

では、何を捨てるのか。

マクスウェル方程式を捨てるのか。
相対性原理を捨てるのか。
光速度不変を捨てるのか。
それとも、絶対時間という考え方を捨てるのか。

アインシュタインが選んだのは、最後の道でした。

この流れは、LLMにとって比較的扱いやすいテーマです。なぜなら、前提と矛盾を整理し、どの仮定を変えるべきかを候補として並べることは、LLMが得意な作業だからです。

さらに、ローレンツ変換の導出は数式として検証できます。

たとえば、変換式を仮定して、「光が x = ct と進むなら、変換後も x’ = ct’ になるか」を確認する。こうした部分はSymPyのような記号計算ツールでチェックできます。

つまり、LLMが考えたように見える部分も、最終的には数式で検証できるのです。

Fable5の答え  LLMは“発見者”ではなく“仮説生成役”

ここが今回の一番大事なポイントです。

Fable5は、LLMを万能の科学者としては扱っていません。むしろ、LLMは「仮説を出す役」として使うべきだと言っています。

これはかなり重要です。

LLMは文章を作るのが得意です。前提を整理したり、いくつかの選択肢を並べたり、もっともらしい説明を作ったりするのも得意です。

しかし、数式の厳密な計算や、長い論理の一貫性維持は苦手です。特に物理や数学では、符号のミス、添字のミス、条件の抜け落ちが簡単に起きます。そして怖いのは、間違っていても自信満々に説明してしまうことです。

だからこそ、LLMに正しさを任せてはいけません。

役割分担としては、LLMは「次にどんな仮説を試すか」を出す。
SymPyは「その式が条件を満たしているか」を検証する。
Pythonは「数値的におかしな挙動がないか」を確認する。
Leanのような形式証明ツールは「重要な定理が本当に成り立つか」を保証する。

このように考えると、LLMは科学者そのものではなく、研究の探索を助ける相棒のような存在になります。

数式の正しさはSymPy・Python・Leanで検証する

Fable5が提案していた初期設計案は、かなり実装しやすいものでした。

まずは一般相対論まで行かず、特殊相対論のローレンツ変換に絞る。

入力するのは、相対性原理、光速度不変、線形性の仮定です。そこからLLMに変換式の候補を出させます。

たとえば、

x’ = γ(x – vt)
t’ = γ(t – vx/c²)

のような形です。

そして、これが本当に光速度不変を満たすかをSymPyで確認する。さらに、低速ではガリレイ変換に近づくか、逆変換が同じ形になるか、時空間隔が保存されるかなどをチェックします。

ここまでできれば、「LLMがローレンツ変換をそれっぽく語った」ではなく、「LLMが出した候補を機械的に検証した」と言えます。

この違いはかなり大きいです。

AIを使った科学実験で重要なのは、AIの説明がうまいかどうかではありません。AIが出した仮説を、外部の検証器で潰せるかどうかです。

もっと言えば、AIにはどんどん間違わせてもいい。大事なのは、間違いを検出し、フィードバックし、次の候補を出させるループを作ることです。

「仮説生成 → 数式検証 → 反例提示 → 再提案」

このループこそが、AIによる理論再構成の本体になります。

「再構成」と「発見」は違う——それでも実験する価値はある

ただし、ここで大きな注意点があります。

現代のLLMは、すでに相対性理論を学習しています。ローレンツ変換も、E=mc²も、アインシュタイン方程式も、知識として知っている。

つまり、LLMが相対性理論を導いたように見えても、それは本当の意味での発見ではなく、学習済み知識の再構成かもしれません。

ここは非常に重要です。

「AIが相対性理論を発見した」と言うには、かなり厳しい条件が必要です。たとえば、1905年以前の知識だけで訓練されたモデルを使う、あるいは相対性理論という固有名詞を完全に隠して、架空の公理系で同じように新しい変換法則を導けるかを試す必要があります。

だから今回のテーマは、正確には「発見」ではなく「再構成」です。

しかし、それでも価値はあります。

なぜなら、既知の理論を題材にすれば、AIがどこまで仮説を出せるか、どこで間違えるか、どの部分を外部ツールで検証すべきかが分かるからです。

相対性理論という既に答えの分かっている山を登らせることで、未知の問題に挑むための訓練ができます。

最初の目標としては、やはり特殊相対論がちょうど良いかと。一般相対論は、「重力は時空の曲がりである」という概念の飛躍が必要で、いきなり扱うには難しすぎます。

まずは、ローレンツ変換をLLMとSymPyで半自動的に導出・検証する。
その次に、時間の遅れや長さの収縮を導く。
さらに進めるなら、E=mc²や重力赤方偏移へ拡張する。

この順番なら、かなり現実的です。

まとめ

AIは今すぐアインシュタインになるわけではありません。
しかし、矛盾を見つけ、仮説を出し、検証器で間違いを潰していく仕組みを作れば、科学的な思考の一部を再現することはできます。

Fable5の回答は、その方向性をかなり明確に示していました。

LLMは発見者ではなく、探索の案内役。
正しさを決めるのは、数式処理、数値計算、形式証明。
そして人間は、その全体を設計する。

AIで科学をするとは、AIにすべてを任せることではありません。
AIと検証ツールを組み合わせて、間違いながら前に進む仕組みを作ることです。

その第一歩として、「相対性理論の再構成」はかなり面白い実験テーマだと思います。

巻末 Fable5の回答を公開

************

●先に記します。ここでのFable5の回答を次の見出しでGPT5.6 solに修正してもらっています。

数式のところをちょいと直したようです。

まあ、かなりハイレベルの修正となっていますので、合わせてご覧くださればと。
では、どうぞ。

**********ここからFable5の回答 原文ママ

# LLMによる相対性理論の「再構成」——段階的考察

## 全体像

### 相対性理論とは何を説明する理論か

まず前提を整理します。

ニュートン力学は「絶対時間・絶対空間」を前提とします。
つまり、宇宙のどこでも誰にとっても時間は同じ速さで流れ、空間は固定された舞台である、という考え方です。

速度は単純に足し算でき、座標変換はガリレイ変換で扱えます。
また、重力は「距離の2乗に反比例する、瞬時に伝わる力」として説明されます。

しかし相対性理論は、この前提を2段階で覆しました。

| 項目 | 特殊相対性理論 | 一般相対性理論 |
| —— | ——————- | ————- |
| 発表年 | 1905年 | 1915年 |
| 対象 | 慣性系どうしの関係 | 加速系・重力を含む全座標系 |
| 核となる原理 | 相対性原理+光速度不変 | 等価原理+一般共変性 |
| 主な帰結 | 時間の遅れ、長さの収縮、E = mc² | 時空の曲率としての重力 |

特殊相対性理論の出発点は、光速度不変です。
真空中の光速 c は、光源や観測者の運動状態によらず一定である、という原理です。

これは「速度は足し算できる」という直観と真っ向から衝突します。

この矛盾を解消するには、時間と空間を独立したものではなく、観測者ごとに混ざり合う4次元時空の成分として扱う必要があります。

不変なのは、時間そのものでも距離そのものでもありません。
不変なのは、次の「時空間隔」です。

**ds² = −c²dt² + dx² + dy² + dz²**

ここで、時間方向の成分と空間方向の成分を合わせた量が、観測者が変わっても保存されます。

一方、一般相対性理論では、重力は「力」ではなく「時空の曲がり」として再解釈されます。
物体は曲がった時空の中で最も自然な経路、つまり測地線を進みます。
それが地上では「落下」として見える、という考え方です。

—

## LLMで「導く」とはどういうことか

ここで重要なのは、LLMは厳密な演繹機械ではない、という点です。

LLMは、人間のように公理から必ず正しい結論を導く機械ではありません。
むしろ、過去に学習した膨大な文章や数式のパターンから、次に来る可能性の高い内容を補完する機械です。

そのため、LLMで相対性理論を「再構成」するなら、次のような分業が必要になります。

1. 歴史上の発見プロセスを、推論ステップの連鎖として分解する
2. 各ステップでLLMに、矛盾の指摘、仮説の生成、数式変形の提案をさせる
3. 数式の正しさは、SymPyなどの外部ツールで検証する

つまり、LLMにすべてを任せるのではなく、LLMを「仮説を出す役」として使い、正しさの確認は記号計算や形式証明に任せる、という設計が重要になります。

—

## LLMに与えるべき最小限の入力情報

### 特殊相対論向けの知識セット

1905年以前の知識だけで特殊相対性理論を再構成させるなら、次のような情報が必要になります。

| カテゴリ | 内容 | 役割 |
| —- | ————- | ——————- |
| 実験事実 | マイケルソン・モーリー実験 | エーテル風が検出されないという矛盾の種 |
| 理論 | マクスウェル方程式 | 光速が定数として理論に埋め込まれている |
| 理論 | ガリレイ変換 | 破綻させるべき旧枠組み |
| 原理 | 相対性原理 | すべての慣性系は対等であるという公理 |
| ヒント | ローレンツ収縮、局所時間 | 与えるかどうかで難易度が変わる補助情報 |

特に大事なのは、ガリレイ変換です。

**x′ = x − vt**

**t′ = t**

この変換では、時間 t はどの観測者にとっても同じものとして扱われます。
つまり、絶対時間を前提にしているわけです。

しかし、この絶対時間の考え方が、光速度不変と衝突します。

—

### 一般相対論向けの知識セット

一般相対性理論を再構成させる場合は、さらに難しくなります。
必要になる材料は、特殊相対論よりもかなり高度です。

| カテゴリ | 内容 | 役割 |
| —- | ————– | ———— |
| 実験事実 | 慣性質量 = 重力質量 | 等価原理の根拠 |
| 観測 | 水星近日点移動の残差 | ニュートン重力の破れ |
| 理論 | 特殊相対論 | 出発点 |
| 数学 | リーマン幾何学、テンソル解析 | 時空の曲率を扱う道具 |
| 原理 | 等価原理、一般共変性 | 方程式を絞るための公理 |
| 整合条件 | エネルギー運動量保存 | 場の方程式の形を制約する |

ここで重要なのは、「事実」「旧理論」「原理」「数学的道具」「整合条件」を分けて与えることです。

これらが混ざっていると、LLMは既知の結論をそのまま吐き出してしまいやすくなります。
つまり、「考えて導いた」のではなく、「知っている答えを出した」だけになる危険があります。

—

# 特殊相対性理論を導く流れ

## Step 1:矛盾の検出

LLMにまず問うべきことは、次のような問いです。

「マクスウェル方程式にガリレイ変換を適用するとどうなるか?」

マクスウェル方程式から導かれる光の波動方程式は、簡単に書くと次の形になります。

**∂²φ/∂x² − (1/c²)∂²φ/∂t² = 0**

この式では、光の速度 c が定数として現れます。

ところが、ガリレイ変換を使うと、この波動方程式の形が保たれません。
つまり、ニュートン力学の座標変換では、電磁気学の法則がすべての慣性系で同じ形にならないのです。

このことは、「電磁気学が正しく成り立つ特別な慣性系」が存在するはずだ、という考えにつながります。
当時は、それがエーテル静止系だと考えられていました。

しかし、マイケルソン・モーリー実験では、そのエーテル風は検出されませんでした。

ここに大きな矛盾があります。

—

## Step 2:仮定の整理

次に、LLMには選択肢を列挙させます。

考えられる選択肢は、たとえば次の通りです。

1. マクスウェル方程式が間違っている
2. 相対性原理を捨てる
3. エーテルに対する物体の収縮を仮定する
4. ガリレイ変換、つまり絶対時間を捨てる

1つ目の「マクスウェル方程式が間違っている」は、実験的に支持されすぎているため採用しにくい選択肢です。

2つ目の「相対性原理を捨てる」も、エーテル風が観測されないことと整合しません。

3つ目の「物体がエーテルに対して縮む」という考えは、ローレンツ収縮として知られますが、当初はやや応急処置的な仮説でした。

そこで、アインシュタインが選んだのが4つ目です。
つまり、ガリレイ変換を捨てる。
もっと言えば、「絶対時間」を捨てる、という選択です。

ここでLLMに、

「絶対時間を捨てると、何を再定義する必要があるか?」

と問うと、理想的には「同時性の定義」に行き着きます。

—

## Step 3:思考実験——同時性の相対性

有名なのが、列車の思考実験です。

走っている列車の中央から、前方と後方に向かって同時に光を放ちます。
列車の中にいる人から見ると、光は前後の壁に同時に届きます。

しかし、地上にいる人から見ると、列車は動いています。
後方の壁は光に近づき、前方の壁は光から遠ざかります。

そのため、地上の人から見ると、後方の壁に光が先に届きます。

つまり、列車内の人にとって「同時」だった出来事が、地上の人にとっては「同時ではない」のです。

ここから分かることは、同時性は絶対的なものではなく、観測者に依存するということです。

これが、

**t′ = t**

を捨てることの物理的な意味です。

—

## Step 4:ローレンツ変換の導出

次に、LLMにローレンツ変換を導く流れを提案させます。

まず、空間と時間の変換は線形であると仮定します。
これは、空間と時間が一様であるという前提から自然に出てくる仮定です。

最初の候補として、次のような形を置きます。

**x′ = γ(x − vt)**

**t′ = γ(t − αx)**

ここで γ と α は、まだ決まっていない係数です。

この変換に対して、次の条件を課します。

条件1:光速はどの慣性系でも c である。
つまり、

**x = ct のとき、x′ = ct′**

が成り立つ必要があります。

条件2:逆変換は、速度 v を −v に変えた同じ形になる。
これは、相対性原理を表しています。

これらの条件を連立して解くと、次のローレンツ変換が得られます。

**x′ = γ(x − vt)**

**t′ = γ(t − vx/c²)**

**γ = 1 / √(1 − v²/c²)**

この γ は、ローレンツ因子と呼ばれます。

速度 v が光速 c に比べて十分小さいとき、γ はほぼ1になります。
そのため、低速の世界ではローレンツ変換はほとんどガリレイ変換と同じになります。

しかし、速度 v が光速 c に近づくと、γ は急激に大きくなります。
ここから、時間の遅れや長さの収縮といった特殊相対論の効果が現れます。

この部分は記号計算で扱いやすく、SymPyで機械的に検証できます。

—

## Step 5:帰結の導出

ローレンツ変換から、特殊相対性理論の有名な帰結が出てきます。

まず、時間の遅れです。

**Δt′ = Δt / γ**

動いている時計は、静止している観測者から見ると遅れて進むように見えます。

直感的には、光時計を考えると分かりやすいです。
動いている光時計では、光が上下にまっすぐ進むのではなく、斜めに長い距離を進みます。
そのため、1往復にかかる時間が長くなります。

次に、長さの収縮です。

**L′ = L / γ**

動いている物体は、進行方向に縮んで見えます。

ただし、これは単に「物体が物理的につぶれる」という意味ではありません。
観測者ごとに「同時に測る」という条件がずれるため、長さの測定結果が変わるのです。

速度の合成則も、ニュートン力学とは異なります。

**u′ = (u − v) / (1 − uv/c²)**

この式では、速度をどれだけ合成しても光速 c を超えません。
つまり、光速 c が宇宙の速度制限として自然に現れます。

—

## Step 6:E = mc² への流れ

特殊相対性理論からは、エネルギーと質量の関係も導かれます。

まず、4元運動量を次のように定義します。

**p^μ = m(γc, γv)**

ここで、時間方向の成分がエネルギーに対応し、空間方向の成分が運動量に対応します。

エネルギーを低速で展開すると、次のようになります。

**γmc² ≈ mc² + ½mv² + …**

この式の右辺を見ると、2つの重要な項が現れています。

1つ目は、

**mc²**

です。

これは、物体が静止していても持っているエネルギーです。
つまり、静止エネルギーです。

2つ目は、

**½mv²**

です。

これはニュートン力学でおなじみの運動エネルギーです。

ここから、質量そのものがエネルギーを持つという考えが出てきます。
それが有名な式、

**E = mc²**

です。

直感的に言えば、「エネルギーには慣性がある」ということです。
光を放出した物体は、その分だけわずかに軽くなります。

—

## 1905年以前の知識だけで到達できるか

特殊相対性理論については、かなり到達できる可能性が高いと考えられます。

なぜなら、ローレンツやポアンカレは1904年までに、ローレンツ変換そのものにはかなり近いところまで到達していたからです。

つまり、数学的な材料はすでに揃っていました。

欠けていたのは、「絶対時間を捨てる」という概念的ジャンプです。
ローレンツ変換を単なる計算上の工夫ではなく、時空そのものの構造として解釈することが必要でした。

LLMは、複数の仮説を列挙して比較することが得意です。
そのため、「絶対時間を捨てる」という選択肢を候補として出すこと自体は、十分期待できます。

ただし注意点があります。

現代のLLMは、すでに相対性理論を学習しています。
そのため、再構成に見えても、実際には既知の知識を思い出しているだけかもしれません。

本当に「発見能力」を検証するには、1905年以前の文献だけで訓練したモデルが必要になります。

—

# 一般相対性理論を導く流れ

## Step 1:矛盾の検出

一般相対性理論の出発点は、ニュートン重力と特殊相対性理論の矛盾です。

ニュートン重力では、重力は瞬時に伝わる遠隔作用として扱われます。
しかし、特殊相対性理論では、情報や影響は光速 c を超えて伝わることができません。

つまり、ニュートン重力をそのままでは特殊相対論と両立させることができません。

ここから、重力を相対論化する必要が出てきます。

—

## Step 2:等価原理

次に重要になるのが、等価原理です。

観測事実として、慣性質量と重力質量は非常に高い精度で等しいことが知られています。

ここで、LLMに次のように問います。

「すべての物体が同じ加速度で落ちるなら、自由落下する箱の中で重力は検出できるか?」

期待される答えは、「できない」です。

自由落下している箱の中では、物体はふわふわ浮いているように見えます。
局所的には、重力のない慣性系と区別できません。

逆に、宇宙空間で加速するエレベーターの中にいる人は、床に押しつけられる感覚を持ちます。
これは、重力場の中にいる感覚と区別できません。

ここから、

「重力と加速度は局所的には区別できない」

という考えが出てきます。

これが等価原理です。

重力が座標系の選び方で局所的に消せるなら、重力は普通の力ではないのではないか。
ここから、「重力 = 時空の幾何」という考えに進みます。

—

## Step 3:加速度と幾何

次に、回転円盤の思考実験を考えます。

回転する円盤の縁では、円周方向に運動しているため、ローレンツ収縮が起こります。
一方で、半径方向にはそのような収縮は起こりません。

すると、円周と直径の関係が通常のユークリッド幾何とはずれてきます。

つまり、

**円周 / 直径 ≠ π**

となる可能性が出てきます。

これは、加速系ではユークリッド幾何が成り立たないことを示しています。

等価原理によれば、加速系と重力場は局所的に区別できません。
したがって、重力場でも時空の幾何が曲がっていると考えることができます。

また、加速するエレベーターの中では、上下で時計の進み方が異なります。
これは光のドップラー効果から導くことができます。

等価原理を使えば、重力場でも同じことが起こると考えられます。
これが重力赤方偏移です。

近似的には、次の式で表されます。

**Δν / ν ≈ gh / c²**

ここで、g は重力加速度、h は高さの差、c は光速です。

高さが違う場所では、重力ポテンシャルの違いによって、光の振動数がわずかに変化します。

—

## Step 4:測地線と計量

一般相対性理論では、時空の幾何を計量テンソルで記述します。

計量テンソルは、通常次のように書かれます。

**g_μν**

この g_μν が、時空の距離や時間の測り方を決めます。

自由粒子は、曲がった時空の中で最も自然な経路を進みます。
この経路を測地線と呼びます。

測地線方程式は、次のように書かれます。

**d²x^μ / dτ² + Γ^μ_{αβ}(dx^α/dτ)(dx^β/dτ) = 0**

この式は一見難しく見えますが、意味はシンプルです。

物体は「重力に引っ張られて曲がる」のではありません。
曲がった時空の中を、できるだけまっすぐ進んでいるのです。

地上でボールが放物線を描くのは、時空の側が曲がっているからだ、と解釈できます。

弱い重力場、かつ低速の極限では、一般相対性理論はニュートン力学に戻らなければなりません。

この対応を確認するために、計量の時間成分を次のように近似します。

**g₀₀ ≈ −(1 + 2Φ/c²)**

ここで Φ はニュートン重力のポテンシャルです。

この近似を測地線方程式に入れると、ニュートンの運動方程式に対応する形が出てきます。
これが対応原理のチェックです。

—

## Step 5:場の方程式の探索

一般相対性理論で最も難しいのが、場の方程式を見つける段階です。

求める方程式には、次の条件が必要です。

1. テンソル方程式であること
2. 一般共変性を満たすこと
3. 計量の2階微分までを含むこと
4. ニュートンのポアソン方程式に対応すること
5. 右辺にエネルギー運動量テンソル T_μν が来ること
6. 保存則と整合すること

ニュートン重力では、重力ポテンシャル Φ は次のポアソン方程式に従います。

**∇²Φ = 4πGρ**

一般相対性理論では、この式を時空全体に拡張する必要があります。

最初に考えられる素朴な候補は、

**R_μν = κT_μν**

のような形です。

しかし、この形は保存則と整合しません。

ここで重要になるのが、ビアンキ恒等式です。

**∇_μ (R^μν − ½g^μνR) = 0**

この式を使うと、保存則と整合する左辺の形がほぼ絞られます。

そこで、次のアインシュタインテンソルを定義します。

**G_μν ≡ R_μν − ½g_μνR**

この G_μν は、共変発散がゼロになる性質を持ちます。

そして最終的に、一般相対性理論の中心方程式であるアインシュタイン方程式に到達します。

**G_μν ≡ R_μν − ½g_μνR = (8πG/c⁴)T_μν**

この式の意味は、直感的には次のように読めます。

左辺は、時空の曲がり具合。
右辺は、そこに存在する物質やエネルギーの分布。

つまり、

「物質が時空に曲がり方を教え、時空が物質に動き方を教える」

という関係です。

—

## Step 6:観測による検証

一般相対性理論は、単なる美しい数学ではありません。
観測によって検証される必要があります。

代表的な検証は、次の3つです。

1. 水星近日点移動
2. 光の湾曲
3. 重力赤方偏移

水星の近日点移動では、ニュートン力学では説明しきれない残差がありました。
一般相対性理論は、この残差である約43秒角/世紀を説明しました。

光の湾曲では、太陽の近くを通る光が曲がることが予言されました。
太陽縁での曲がりは、約1.75秒角です。
これは1919年のエディントン観測によって有名になりました。

重力赤方偏移は、重力場の違いによって光の振動数が変わる現象です。
これは後にポンド・レブカ実験などで検証されました。

—

## 1915年以前の知識だけで到達できるか

一般相対性理論は、特殊相対性理論よりも格段に難しいと考えられます。

有利な点はあります。

リーマン幾何学やテンソル解析は、数学としてすでに存在していました。
また、等価原理という強力な手がかりもあります。

さらに、「保存則と整合するテンソル方程式」という条件を入れると、候補はかなり絞られます。

しかし、不利な点も大きいです。

最大の難所は、

「重力 = 時空の曲率」

という同一視です。

これは、既存の理論から自動的に出てくるものではありません。
等価原理や回転円盤の思考実験は強いヒントになりますが、論理的に必然というほどではありません。

また、当時はノルドストレームのスカラー重力理論など、もっともらしい競合理論も存在しました。

アインシュタイン自身も、数学者グロスマンの助けを借りながら、途中で誤った方程式に進んだ時期がありました。

つまり、一般相対性理論は一本道ではありませんでした。

結論としては、LLMに

「等価原理から曲がった時空へ進む」

という橋渡しのアイデアを与えれば、その先の方程式の絞り込みはLLMと数式処理で再現できる可能性があります。

しかし、その橋渡し自体をLLMが自発的に生み出せるかは疑わしい。
ここが「再構成」と「発見」の大きな境界線です。

—

# LLMにできること、できないこと

## LLMにできること

LLMが得意なのは、次のような作業です。

1. 矛盾の検出
2. 仮説の列挙と比較
3. 数式変形の方針提案
4. 思考実験の説明
5. 歴史的推論の再演

たとえば、

「マクスウェル方程式とガリレイ変換は両立するか?」

と問えば、LLMはかなり自然に矛盾を指摘できます。

また、

「どの前提を捨てるべきか?」

と問えば、複数の選択肢を並べて比較することもできます。

—

## LLMにできないこと・危険なこと

一方で、LLM単体に任せると危険な作業もあります。

まず、数式の厳密な計算です。
長いテンソル計算や添字操作では、符号ミスや添字ミスが頻発します。

また、物理的にもっともらしいが間違っている説明を、自信満々に出すことがあります。

さらに大きな問題が、知識リークです。

現代のLLMは、相対性理論をすでに学習しています。
そのため、「導いた」ように見えても、実際には記憶している答えを再構成しているだけかもしれません。

したがって、LLM単体で理論発見を評価するのは危険です。

必要なのは、次のような外部検証です。

1. SymPyやMathematicaによる記号計算
2. Pythonによる数値シミュレーション
3. LeanやCoqによる形式証明
4. 実験データとの照合

LLMは探索の案内役であり、正しさを保証する役ではありません。

—

# AIシステムとしての設計案

相対論級の理論を半自動で再構成するなら、次のような構成が考えられます。

中心には、全体を管理するオーケストレーターを置きます。

その下に、次のコンポーネントを接続します。

1. LLM
2. 数式処理エンジン
3. 物理シミュレーター
4. 実験データベース
5. 形式証明システム

LLMは、仮説生成役と批評役に分けます。

仮説生成役は、どの前提を疑うか、どの変換式や方程式が候補になるかを提案します。
批評役は、別の視点から反論や反例を探します。

数式処理エンジンは、提案された変換が条件を満たすかを検証します。
たとえば、光速不変、群構造、保存則との整合性などを確認します。

物理シミュレーターは、候補理論から水星軌道や光の湾曲を数値的に計算します。

実験データベースは、マイケルソン・モーリー実験、エトヴェシュ実験、水星近日点移動などのデータを制約条件として持ちます。

形式証明システムは、重要な定理を機械的に検証します。

重要な設計思想は、LLMに正しさを委ねないことです。

LLMは探索のヒューリスティックです。
正しさは、記号計算、数値検証、形式証明の三層で担保します。

—

# MVP実装案

最初のMVPでは、野心を絞るべきです。

いきなり一般相対性理論まで扱うのではなく、まずは特殊相対性理論のローレンツ変換を、原理から半自動で導出・検証するパイプラインを作るのが現実的です。

## MVPのスコープ

入力は、次の3つです。

1. 相対性原理
2. 光速度不変
3. 線形性の仮定

出力は、ローレンツ変換と、その導出ログです。

具体的には、各ステップを次のような形で記録します。

1. 仮定
2. 操作
3. 結果
4. 検証ステータス
5. 物理的解釈

—

## 概念コード

python
class TheoryReconstructionMVP:
def __init__(self):
self.llm = LLMClient()
self.symbolic = SymPyVerifier()
self.numeric = NumericChecker()

def run(self, axioms: list[str]):
state = DerivationState(axioms)

for step in range(MAX_STEPS):
proposal = self.llm.propose_next_step(state)

ok, detail = self.symbolic.verify(proposal)

if not ok:
state.add_feedback(detail)
continue

state.commit(proposal)

if state.goal_reached():
break

return state.derivation_log

この設計では、LLMが次の一手を提案します。
ただし、その提案をそのまま信じるのではなく、SymPyで検証します。

検証に失敗した場合は、そのエラーをLLMに返します。
LLMはそのフィードバックを受けて、次の候補を出します。

—

## SymPyで検証する項目

たとえば、ローレンツ変換の候補を次のように置きます。

python
import sympy as sp

x, t, v, c = sp.symbols('x t v c', real=True)
g, a = sp.symbols('gamma alpha', positive=True)

xp = g * (x - v*t)
tp = g * (t - a*x)

# 条件1: x = c*t のとき xp = c*tp
cond1 = sp.simplify((xp - c*tp).subs(x, c*t))

この条件は、光が x = ct を満たすとき、変換後も x′ = ct′ を満たすかどうかを確認しています。

最終的には、次の結果を確認します。

**α = v/c²**

**γ = 1 / √(1 − v²/c²)**

これにより、ローレンツ変換が得られます。

—

## 評価方法

MVPの評価では、次の点を見るべきです。

1. 導出の正しさ
2. 導出の効率
3. リーク耐性
4. 架空公理系への汎化

導出の正しさは、すべてのステップがSymPy検証を通過するかで評価できます。

導出の効率は、LLMが何回の試行でローレンツ変換に到達したかで測れます。

リーク耐性を見るには、プロンプトから「相対性理論」「ローレンツ」などの固有名詞を除きます。
さらに、変数名もランダム化します。

それでも同じ構造に到達できるかを確認します。

さらに重要なのは、架空の公理系でテストすることです。

たとえば、

「c が無限大の世界」

を与えた場合、ガリレイ変換に戻るべきです。

あるいは、

「光速が方向依存する世界」

を与えた場合、通常のローレンツ変換とは異なる変換が出てくるはずです。

このようなテストができれば、単なる暗記ではなく、条件に応じて推論している可能性を評価できます。

—

# 拡張ロードマップ

MVPが完成したら、次の段階に進めます。

## Phase 2:E = mc² の導出

4元運動量を構成し、低速展開から静止エネルギーを導きます。

**p^μ = m(γc, γv)**

**γmc² ≈ mc² + ½mv² + …**

ここから、

**E = mc²**

を導く流れを検証します。

—

## Phase 3:重力赤方偏移の導出

等価原理とドップラー効果を使って、重力赤方偏移を導きます。

**Δν / ν ≈ gh / c²**

これは、一般相対性理論への入り口として扱いやすいテーマです。

—

## Phase 4:弱場近似でのニュートン極限チェック

一般相対性理論の式が、弱い重力場ではニュートン力学に戻ることを確認します。

そのとき使う近似が、

**g₀₀ ≈ −(1 + 2Φ/c²)**

です。

これを測地線方程式に入れて、ニュートンの運動方程式に対応する形が出るかを調べます。

—

## Phase 5:アインシュタイン方程式の候補探索

最終段階では、保存則と整合する2階のテンソル方程式を探索します。

重要になる式は、ビアンキ恒等式です。

**∇_μ (R^μν − ½g^μνR) = 0**

そして、最終的な候補としてアインシュタイン方程式に到達するかを確認します。

**G_μν ≡ R_μν − ½g_μνR = (8πG/c⁴)T_μν**

ここまで来ると、単なる特殊相対論の再構成ではなく、一般相対性理論の構造探索に近づきます。

—

# まとめ

特殊相対性理論は、比較的「演繹パズル」として扱いやすい理論です。

相対性原理、光速度不変、線形性という前提を与えれば、ローレンツ変換の導出はLLMと数式処理の組み合わせでかなり現実的に再構成できます。

鍵になるのは、絶対時間を捨てるという選択です。

一方、一般相対性理論は、難度が大きく上がります。

特に、

「重力 = 時空の曲率」

という概念的な飛躍は、単純な数式操作から自動的に出てくるものではありません。

ただし、この橋渡しのアイデアを与えれば、その先の場の方程式の探索は、形式化された条件によってかなり絞り込めます。

LLM単体では、数式の厳密性も、知識リークの問題も解決できません。
そのため、SymPy、Mathematica、Lean、数値シミュレーションなどとの連携が必須です。

このプロジェクトの本質は、LLMに天才物理学者の代わりをさせることではありません。

むしろ、

「矛盾検出 → 仮説生成 → 機械検証 → 反例フィードバック」

というループを作ることです。

相対性理論という既知の山を登る練習を通じて、未知の理論探索にも使える汎用パイプラインを作る。
そこに、この試みの価値があります。

巻末 上記のFable5の回答をGPT5.6 solに修正してもらった

原文ママ

結論

**全体としては、おおむね合っています。**
相対性理論の概要、LLMとSymPyの分業、ローレンツ変換をMVPにする方針は、かなり筋が通っています。一般向け解説としては十分使える内容です。

ただし、**数式上の誤解を招く箇所と、歴史を単純化しすぎている箇所が8点ほどあります。**
感覚的には「85点くらい。公開前に要修正」という判定です。

—

## 1.時間の遅れは、記号を明確にした方がよい

記事では、

[
\Delta t’=\frac{\Delta t}{\gamma}
]

となっています。

これは、(t’)を「動いている時計自身が刻む時間」、(t)を「静止系で測った時間」と定義するなら正しいです。アインシュタインの1905年論文でも、

[
\tau=t\sqrt{1-\frac{v^2}{c^2}}
=\frac{t}{\gamma}
]

という関係になっています。

ただ、通常は固有時間を (\Delta\tau) として、

[
\boxed{\Delta t=\gamma\Delta\tau}
]

と書く方が分かりやすいです。

記事では次のように直すのがおすすめです。

> 動いている時計が自身で刻む時間を (\Delta\tau)、静止している観測者が測る時間を (\Delta t) とすると、
>
> [
> \Delta t=\gamma\Delta\tau
> ]
>
> となる。したがって、静止系から見ると動いている時計はゆっくり進む。

—

## 2.長さの収縮も「どちらが静止長か」を明記する

記事の、

[
L’=\frac{L}{\gamma}
]

も、定義次第では正しいのですが、(L)と(L’)のどちらが静止長なのか分かりません。

一般的には、物体と一緒に動く座標系で測った静止長を (L_0) として、

[
\boxed{L=\frac{L_0}{\gamma}}
]

と書きます。アインシュタインの原論文でも、運動方向の長さが (\sqrt{1-v^2/c^2}) 倍になることが示されています。

—

## 3.「E=mc²」は静止エネルギーとして書くべき

記事では最後に、

[
E=mc^2
]

としていますが、厳密には、これは**静止している物体のエネルギー**です。

したがって、

[
\boxed{E_0=mc^2}
]

と書くのが適切です。

動いている物体の全エネルギーは、

[
E=\gamma mc^2
]

です。

さらに厳密に説明するなら、4元運動量を、

[
p^\mu=\left(\frac{E}{c},,\mathbf p\right)
]

と置き、その不変量から、

[
E^2=p^2c^2+m^2c^4
]

を得ます。物体が静止していて (\mathbf p=0) なら、

[
E_0=mc^2
]

となります。

記事の低速展開、

[
\gamma mc^2
\approx mc^2+\frac12mv^2+\cdots
]

自体は正しいです。ただし「一般のエネルギーが常に (mc^2)」と読めないよう、静止エネルギーと全エネルギーを分ける必要があります。アインシュタインの1905年論文も、エネルギー (L) を放出すると質量が (L/c^2) 減少する、という形で質量とエネルギーの対応を述べています。

—

## 4.一般相対論の「核となる原理=一般共変性」は少し強すぎる

表では一般相対論の核を、

> 等価原理+一般共変性

としています。

歴史的な説明としては間違いではありません。ただし、**一般共変性だけでは一般相対論を特徴づけられません。**

ほかの物理理論も、数学的には任意の座標で書ける形に変更できるからです。これはクレッチマンの批判として知られています。([arXiv][1])

表は次のようにすると、より正確です。

| 項目 | 一般相対性理論 |
| —— | ———————— |
| 対象 | 重力と時空の幾何 |
| 核となる考え | 等価原理、動的な計量、一般座標変換に対する共変性 |
| 主な帰結 | 重力による時間の遅れ、光の湾曲、時空の曲率 |

「すべての座標系が物理的に同じ」というより、

> 物理法則を任意の座標で記述でき、計量そのものが物質に応じて変化する

とした方が正確です。

—

## 5.等価原理は「局所的に」という条件が非常に重要

記事には、

> 自由落下する箱の中では重力を検出できない

とあります。

これは、**十分に小さな領域・短い時間に限れば正しい**です。

大きな箱で精密に測定すると、場所によって重力の強さや方向が違うため、潮汐力を検出できます。つまり、時空の曲率そのものは座標変換では消せません。

アインシュタイン自身も、重力場を消せるのは「無限小の領域」であり、有限領域全体では特殊相対論が成立する座標系を一般には作れないと述べています。([Wikisource][2])

次のように直すとよいです。

> 十分に小さな自由落下系では、重力を局所的に消すことができる。ただし、広い領域では潮汐力が残るため、真の重力場と単なる加速系を区別できる。

—

## 6.アインシュタイン方程式には宇宙項の可能性がある

記事では最終式を、

[
G_{\mu\nu}
=\frac{8\pi G}{c^4}T_{\mu\nu}
]

としています。

1915年型の説明としては正しいです。

ただし、「条件から方程式がほぼ一意に決まる」と説明するなら、より一般には、

[
\boxed{
G_{\mu\nu}+\Lambda g_{\mu\nu}
=\frac{8\pi G}{c^4}T_{\mu\nu}
}
]

です。

(\Lambda) は宇宙定数です。

4次元で、計量とその2階微分までから作られ、対称で共変発散がゼロになるテンソルを求めると、アインシュタインテンソルだけでなく (g_{\mu\nu}) に比例する項も許されます。([サイエンスダイレクト][3])

記事では、

> 宇宙定数をゼロと置けば、通常のアインシュタイン方程式になる

と一文入れれば十分です。

—

## 7.マイケルソン・モーリー実験から相対論が必然的に出たわけではない

記事の流れは、

> エーテル風が検出されない
> ↓
> 絶対時間を捨てる

となっています。

教材上は分かりやすいのですが、歴史的・論理的には一本道ではありません。

マイケルソン・モーリー実験は、想定された大きさのエーテル風を検出できませんでした。([American Journal of Science][4])

しかし当時は、

* 物体がエーテルに対して収縮する
* 時計の進み方が運動によって変わる
* エーテルは存在するが観測できない

といったローレンツ型の理論でも説明できました。ポアンカレも、収縮仮説がマイケルソンの実験を説明すると論じています。([吴从军实验室][5])

また、アインシュタインの1905年論文は「地球の光媒質に対する運動を発見しようとする試み」に触れていますが、マイケルソン・モーリー実験を名指ししてはいません。

したがって、

> 実験によって絶対時間の放棄が論理的に強制された

ではなく、

> 複数の説明が可能な中で、アインシュタインは絶対時間とエーテルを不要にする解釈を選んだ

とする方が正確です。

—

## 8.ポアンカレの年代が少しずれている

記事では、

> ローレンツやポアンカレは1904年までに、ローレンツ変換そのものにはかなり近いところまで到達していた

とあります。

ここは次のように分けるべきです。

* **ローレンツ**:1904年に変換式にかなり近い形を提示
* **ポアンカレ**:1905年にローレンツ変換の群構造などを明確化

ポアンカレの「電子の力学」の短報は1905年6月5日に提出されています。([arXiv][6])

したがって修正文は、

> ローレンツは1904年に変換式の数学的材料をかなり整えており、ポアンカレは1905年にその群構造や相対性原理との関係をさらに発展させていた。

がよいです。

—

## 9.SymPyコードは、現状ではγまで求められない

記事のコードでは、

python
cond1 = sp.simplify((xp - c*tp).subs(x, c*t))

までしか実行していません。

この条件だけから求まるのは主に、

[
\alpha=\frac{v}{c^2}
]

です。

(\gamma)を決めるには、さらに逆変換や往復変換を検証して、

[
\gamma^2\left(1-\frac{v^2}{c^2}\right)=1
]

を得る必要があります。

たとえば考え方としては、

python
alpha_solution = sp.solve(
sp.Eq(sp.simplify((xp - c * tp).subs(x, c * t)), 0),
a
)

# 逆変換を行ったとき元の座標に戻る条件から gamma を決める
gamma_eq = sp.Eq(g**2 * (1 - v**2 / c**2), 1)
gamma_solution = sp.solve(gamma_eq, g)

となります。

したがって、

> このコードにより最終的にαとγを確認できる

ではなく、

> このコードは光速不変条件を検査する最初の部分であり、γを決めるには逆変換または群構造の条件を追加する

と書く方が正確です。

—

## 最終判定

**大枠は正しいです。致命的に間違った記事ではありません。**

特に良いのは、

* LLMを仮説生成役に限定している
* 数式検証をSymPyに任せている
* 特殊相対論から始めるMVP設計
* 知識リークを問題として認識している
* 架空公理系で汎化能力を試そうとしている

という部分です。

最低限直したいのは、次の4点です。

1. 時間の遅れと長さの収縮で、固有時間・静止長を明記
2. (E=mc^2)を (E_0=mc^2) とする
3. アインシュタイン方程式に宇宙定数の可能性を加える
4. 「1904年までにポアンカレも到達」を「ポアンカレは1905年」に修正

この4点を直せば、かなり信頼できる記事になります。

[1]: https://arxiv.org/pdf/1506.03512?utm_source=chatgpt.com “Background Independence, Diffeomorphism Invariance, …”
[2]: https://en.wikisource.org/wiki/The_Foundation_of_the_Generalised_Theory_of_Relativity “The Foundation of the Generalised Theory of Relativity – Wikisource, the free online library”
[3]: https://www.sciencedirect.com/science/article/pii/S0393044011001276?utm_source=chatgpt.com “Lovelock’s theorem revisited”
[4]: https://ajsonline.org/article/62505-on-the-relative-motion-of-the-earth-and-the-luminiferous-ether “On the Relative Motion of the Earth and the Luminiferous Ether | Published in American Journal of Science”
[5]: https://wucj.lab.westlake.edu.cn/Others/Poincare_July1905.pdf?utm_source=chatgpt.com “On the Dynamics of the Electron”
[6]: https://arxiv.org/pdf/1204.6576?utm_source=chatgpt.com “Poincaré’s Dynamics of the Electron – A Theory of Relativity?”

****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

AlphaProofの簡易版でアインシュタインの三平方の定理証明を実装してみた

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

おつかれさんです。
いやー アンソロピックさんのFable5の突然BAN。
フロンティアモデルが一発でBANされるなんて。

もっと使っとけばなあ。
実力はすごかったですよね。
早く復活して欲しいですわな。

そんなこんなで今回は
アート系でも、ビジネス系でもなく、
AI for サイエンス(あえてカタカナで)
これ系でいってみます。

さて、下記の記事に興味があったので、簡易版のAlphaProofを実装してみました。
https://ledge.ai/articles/deepmind_alphaproof_nexus_erdos_problems

本家 Deepmindのブログ (英文)
https://deepmind.google/blog/ai-solves-imo-problems-at-silver-medal-level/

以下の記事は数式がちょこちょこ出てきます。
数式はちょっとなあという方は読み飛ばしてください。

簡易版AlphaProofで数学証明に挑戦

今回は、ローカルPC上に作った簡易版AlphaProofを使って、アインシュタイン型の三平方の定理証明をLeanで実装してみました。

といっても、ここで使ったのは本家のAlphaProofそのものではありません。
Leanの証明コードを自動修正するための簡易的な証明エージェントです。

Leanでは、数学の証明をコードとして書くことができます。

そして、そのコードが本当に正しいかどうかを、Leanが厳密にチェックしてくれます。

つまり、ただ「それっぽい説明」を書くのではなく、
コンピューターに検査される形で数学の証明を書くということです。

今回はその題材として、誰でも一度は聞いたことがある「三平方の定理」を選びました。

しかも、普通の三平方の定理ではなく、
「アインシュタインが若いころに考えた」と言われるタイプの証明をテーマにしています。

AlphaProofとは

AlphaProofは、Google DeepMindが発表した数学証明AIの仕組みです。自然言語で書かれた数学問題を、Leanのような形式言語で扱える形に変換し、コンピューター上で正しい証明を探索します。

2024年には、AlphaProofとAlphaGeometry 2を組み合わせたシステムが、国際数学オリンピックの問題で銀メダル相当の成績を出したことでも注目されました。

さらにその後、関連する研究としてAlphaProof Nexusという枠組みも報告されています。
これは大規模言語モデルによる証明案の生成と、Leanによる機械的な検証を組み合わせるもので、エルデシュ問題と呼ばれる未解決数学問題のうち、353件に挑戦して9件を解決したとされています。

ここで重要なのは、AIがただ文章で「それっぽい証明」を作るのではなく、Leanによって証明が本当に正しいか検査される点です。
今回使ったものは本家AlphaProofではなく、その考え方に着想を得てローカルで作った簡易版です。

アインシュタインの三平方の定理証明とは

三平方の定理は、直角三角形について成り立つ有名な定理です。

直角をはさむ2つの辺を a と b、斜めの一番長い辺を c とすると、

a² + b² = c²
になります。

学校では、正方形を描いて面積で説明する証明を見た人も多いと思います。

一方、アインシュタイン型の証明は少し雰囲気が違います。

直角三角形の中に、もう一本線を引きます。

直角のところから、斜辺に向かって垂直に線を下ろすのです。

すると、もとの大きな直角三角形が、2つの小さな直角三角形に分かれます。

Screenshot

ここで面白いのは、
大きな三角形と、分かれた2つの小さな三角形が、全部同じ形になる
という点です。

大きさは違います。

でも形は同じです。

数学では、こういう関係を相似と呼びます。

この「相似」という考え方を使うことで、三平方の定理をとてもすっきり導くことができます。

今回Leanで証明する範囲:幾何全体ではなく読み物としての核心へ

ただし、今回いきなり全部をLeanで証明したわけではありません。

ここはかなり大事です。

本当に厳密にやるなら、Leanの中で、

点A、点B、点Cを定義する
直角三角形であることを定義する
Cから斜辺に垂線を下ろす
3つの三角形が相似であることを証明する
相似なら面積比が辺の2乗比になることを証明する

というところまで全部やる必要があります。

これはかなり大きな作業になります。

そこで今回は、まず一番おいしい部分だけを切り出しました。

それが、
相似三角形の面積比から、三平方の式を導く部分
です。

アインシュタイン型の証明では、3つの三角形が相似になります。

相似な図形では、長さが2倍になれば面積は4倍になります。
長さが3倍になれば、面積は9倍になります。

つまり、面積は長さの2乗に比例します。

この考え方から、

大きい三角形の面積は c² に比例
小さい三角形の一方の面積は a² に比例
もう一方の面積は b² に比例

と考えられます。

そして、大きい三角形は、小さい三角形2つを合わせたものです。
だから、

c² に比例する面積
=
a² に比例する面積
+
b² に比例する面積
となります。

ここから、
c² = a² + b²
が出てくるわけです。

今回Leanで証明したのは、まさにこの部分です。

言い換えると、
図形そのものを完全に証明したのではなく、アインシュタイン型証明の代数コアを形式検証した
という位置づけです。

証明ターゲットを作成する

次に、簡易版AlphaProofに渡すためのLeanファイルを作りました。

Leanでは、まだ証明が完成していない部分に sorry と書くことができます。

これは、ざっくり言えば、
ここはあとで証明する
という印です。

今回の流れでは、まずsorry 入りの証明ターゲットを作りました。

そして、その未完成のLeanファイルを、簡易版AlphaProofに渡して、自動修正できるかを試しました。

最初に狙ったのは、次のような証明です。

c² × k = a² × k + b² × k
k は 0 ではない
だから
c² = a² + b²

ここで k は、面積が辺の2乗に比例するときの共通の係数です。

三角形の形が同じなら、面積は「斜辺の長さの2乗 × 共通係数」の形で表せます。

この共通係数 k が両辺にかかっているので、
k が0でなければ消すことができます。

人間が見れば当たり前に思える操作ですが、Leanではそれをきちんと証明として書く必要があります。

簡易版AlphaProofで証明を自動修正する

準備したLeanファイルを、ローカルの簡易版AlphaProofに渡して実行しました。
実行後、成功ファイルが出力されました。

その中では、未完成だった証明が、Leanで通る形に修正されています。

証明の流れを日本語で書くと、こうです。
まず、
c² × k = a² × k + b² × k
という前提があります。

右側の
a² × k + b² × k
は、まとめると、

(a² + b²) × k
になります。

だから、
c² × k = (a² + b²) × k
です。

そして、k ≠ 0 なので、両辺の k を消せます。

その結果、
c² = a² + b²
が得られます。

Leanのコードでは、この「共通因子を消す」操作がきちんと書かれていました。

これにより、アインシュタイン型三平方証明の中核である、
面積比から三平方の式を導く部分をLeanで証明できたとなります。

間違った証明コードとの比較と今回分かったこと

今回はさらに、比較実験も行いました。
ただ正しい証明が通っただけでは、記事として少し物足りません。
そこで、あえて間違った証明コードも用意しました。

最初に試したのは、命題自体は正しいけれど、証明コードだけが間違っているパターンです。

具体的には、証明部分に ring だけを書きました。

ring は代数式を整理するためのLeanの機能です。
しかし今回の証明では、単に式を整理するだけでは足りません。

前提として与えられた式を使い、さらに k ≠ 0 という条件を使って、共通因子 k を消す必要があります。
そのため、ring だけでは証明として不十分です。

ところが、簡易版AlphaProofを実行すると、この間違った証明コードは修正されました。
最終的には、ちゃんと前提を使い、k ≠ 0 によって共通因子を消す形に直されました。

つまり、
正しい命題に対して、証明コードが不十分だった場合は、簡易版AlphaProofで修正できた
ということです。

偽の命題も試してみる

次に、もっと重要な実験として、数学的に偽の命題も試しました。

本来の証明では、k ≠ 0 が必要です。
そこで、あえてこの条件を外してみました。
するとどうなるか。

もし k = 0 なら、
c² × 0 = a² × 0 + b² × 0
はいつでも成り立ちます。

左も右も0になるからです。

でも、そこから
c² = a² + b²
が成り立つとは限りません。

つまり、k ≠ 0 を外した命題は、数学的には正しくありません。

この偽の命題は、簡易版AlphaProofでも証明できませんでした。

これはかなり大事な結果です。
AIが何でもかんでも「それっぽい証明」を作って通してしまうわけではありません。

最終的にはLeanが、
その証明が本当に正しいかどうか
を厳密にチェックしているということです。

今回の実験で見えたこと

今回の実験で分かったことは、大きく3つあります。

1つ目は、簡易版AlphaProofでも、正しい命題に対してはLean証明を自動修正できる場合があることです。

2つ目は、証明コードが多少間違っていても、適切な形に直せる可能性があることです。

3つ目は、数学的に偽の命題は、最終的にはLeanで通らないということです。

今回実装できたのは、三平方の定理の完全な幾何証明ではありません。

しかし、アインシュタイン型証明の中核である、
相似三角形の面積比
↓
c²k = a²k + b²k
↓
c² = a² + b²
という流れは、Leanで形式証明できました。

読み物として見れば、これはかなり面白い結果です。

数学の証明をAIに任せるのではなく、
AIが証明案を作り、Leanがそれを厳密に検査する。

この役割分担が見える実験になりました。

今後は、さらに一歩進めて、垂線や相似そのものをLeanで扱う方向に進めると、より本格的な幾何証明に近づいていけそうです。

今回使ったleanコードの一例

あくまでもほんの一例です。
そのうちに、本体をGitにアップしようかと。

下記は表示バグで、インデントいまいちです。
お気に入りのAIに修正してもらってください。


import Mathlib

theorem pythagoras_from_area_ratio
{a b c k : ℝ}
(hk : k ≠ 0)
(h : c^2 * k = a^2 * k + b^2 * k) :
c^2 = a^2 + b^2 := by
apply mul_right_cancel₀ hk
calc
c^2 * k = a^2 * k + b^2 * k := h
_ = (a^2 + b^2) * k := by ring


****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

各種AIシミュレーション紹介・販売ページの開設

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

旧「LINEチャットボット屋」のページは終了しました。
興味のある方はお問い合わせください。

***************

各種AIシミュレーション販売専用ページを公開しました

このたび、各種AIシミュレーションを紹介・販売するための専用ページを公開しました。

Product Shop

これまで個別にご案内していたシミュレーション商品を、より見やすく、わかりやすく確認できるようにするため、専用ページとしてまとめています。

どんなAIシミュレーションを扱っているのか

AIシミュレーションは、数字や条件をもとにして、将来の動きや結果を事前に確認するためのツールです。

たとえば、売上予測、需要の変化、収支の確認、事業計画の検討など、さまざまな場面で活用できます。

「実際にやってみないとわからないこと」を、事前にある程度イメージできるのがシミュレーションの大きなメリットです。

ビジネスの判断材料として使ったり、社内説明の資料づくりに活用したり、サービス内容によっては教育・研修用としても利用できます。

専用ページから確認・お問い合わせできます

専用ページでは、各シミュレーション商品の内容を確認できるようにしています。

気になる商品がありましたら、ページ内のお問い合わせボタンからご連絡ください。

「こういう用途で使えるか知りたい」
「自社向けに少し内容を変えられるか相談したい」
といったお問い合わせも歓迎です。

今後も、用途に合わせたシミュレーション商品を追加していく予定です。

数字をもとに判断したい方、事業や企画の検討材料がほしい方は、ぜひ一度、専用ページをご覧ください。
Product Shop

****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

契約書を読むのが面倒。NotebookLMで内容確認をラクにする方法

********

各種AIシミュレーション紹介・販売ページはこちら。
Product Shop

売上予測や需要変化、収支確認など、事業判断に役立つAIシミュレーションをわかりやすくまとめています。
数字をもとに検討したい方や、企画・業務改善の参考資料を探している方は、ぜひ一度ご覧ください。

AIシミュレーションについてのお問い合わせも下記で受付中
↓↓↓

***************

契約書を読むのが面倒

契約書は大事だけど、読むのがとにかく面倒

契約書や利用規約、申込書、覚書などの書類は、仕事でも日常生活でも意外とよく出てきます。

たとえば、業務委託契約書、賃貸契約書、サービス利用契約、外注先との取り決め、秘密保持契約などです。

ウチでも契約時にはこういった書類を作ったりするのですが、いかんせん読むのが面倒。
なんとかならないかなとは常に思っていました。

文字が細かい。
文章がかたい。
似たような表現が何度も出てくる。

しかも、どこが重要なのかが一目ではわかりにくい。

そのため、つい「だいたい大丈夫だろう」と思って、流し読みしてしまうことがあります。

でも契約書には、あとから大きく影響する内容が書かれていることがあります。

契約期間はいつまでか。
途中で解約できるのか。
支払いはいつ発生するのか。
違約金はあるのか。
禁止されている行為は何か。

こうした点を見落とすと、あとで困る可能性があります。

そこで役立つのが、GoogleのAIノートツールである「NotebookLM」です。

スマホアプリ、PCアプリといろいろあるので、ダウンロードして使ってみてください。

このアプリは何をするのかと言うと、GoogleのAIがアップロードされた書類のみについて質問に答えてくれると言うものです。

通常のchatGPTとかGemmniなんかだと、一般的な知識で答えますよね。

そのAIが学習したその知識を加味して答えるんですが、このnotebookLMはアップロードされた書類のみについて答えるので、余計な事は 回答しないように設計されています

ただし、注意点があって、アップロードした書類は、Googleのサーバーにアップされるので、社内の超機密情報などはアップしないほうがよろしいかと思います。

まぁ多少見られても問題ない。そんな書類ならいくらでもアップロードして使ってみたらと思います。

超重要な社内機密情報なんかは、こういった汎用されたアプリを使わずに、独自のAI対応のRAGシステムなんかを作って、社内専門でいろいろ使ったほうがよろしいかと思います。

さて、そんなNotebookLMを使うと、契約書の内容を読み込ませて、それについて、いろいろ質問することができます。

つまり、契約書を最初から最後まで自力で読む前に、気になるポイントをAIに質問しながら確認できるのです。


NotebookLMを使えば、契約書の内容を質問できる

NotebookLMは、読み込ませた資料をもとに、内容を整理したり、質問に答えたりしてくれるツールです。

通常のAIチャットと違う点は、こちらがアップロードした資料を中心に回答してくれるところです。

たとえば、契約書を読み込ませたあとに、次のような質問ができます。

「この契約の期間はいつまでですか?」
「途中解約はできますか?」
「支払い条件をわかりやすく説明してください」
「こちら側が注意すべき条文はありますか?」
「違約金に関する記載はありますか?」

このように、契約書の中から知りたいことを質問できるのが大きなメリットです。

契約書を読むときに大変なのは、文章量そのものだけではありません。

本当に大変なのは、
「結局、何が重要なのか」
「自分はどこを見ればいいのか」
「この表現はどういう意味なのか」
という部分です。

NotebookLMを使うと、この部分を会話形式で確認できます。

たとえば、自分で契約書を読んでいて「解約」という言葉が出てきたとします。

そのときに、
「解約について書かれている部分をまとめてください」
と質問すれば、関連する内容を整理してくれます。

さらに、「この契約では、どんな場合に解約できますか?」
と聞けば、より具体的に確認できます。

つまり、契約書を読む作業が、読むだけの作業から、質問しながら理解する作業に変わるのです。

これはかなり大きな違いです。

簡単な契約書を用意してNotebookLMに読み込ませる

今回は、ブログ記事用の例として、簡単な契約書を用意します。

たとえば、次のような業務委託契約書を想定します。
内容はシンプルで、ある人が、ブログ記事の作成を外部ライターに依頼する契約です。

主な内容は次のようなものです。

*********

契約期間は、2026年6月1日から2026年8月31日まで。

業務内容は、ブログ記事の作成。

報酬は1記事あたり5,000円。

納品後、依頼者が内容を確認し、問題がなければ翌月末に支払う。

契約を途中で解約する場合は、原則として14日前までに相手へ通知する。

納品物の著作権は、報酬の支払い完了後に依頼者へ移る。

秘密情報を第三者に漏らしてはいけない。

************

このような簡単な契約書でも、読む側からすると確認するポイントはいくつもあります。

特に重要なのは、契約期間、報酬、支払い時期、解約条件、著作権、秘密保持などです。

これらをすべて自分で探すのは、少し面倒です。
そこで、この契約書をNotebookLMに読み込ませます。

使い方としては、まずNotebookLMで新しいノートブックを作成します。
次に、契約書のテキストやPDFを資料として追加します。
読み込みが完了したら、あとはその契約書について質問できます。

ここで大事なのは、いきなり難しい質問をする必要はないということです。

最初はシンプルに、
「この契約書の内容をわかりやすく要約してください」と聞くだけでも十分です。

すると、契約書全体の概要をつかみやすくなります。
そのあとで、気になる点を一つずつ質問していきます。

「契約期間は?」「解約条件は?」と質問してみる

契約書をNotebookLMに読み込ませたら、実際に質問してみます。
まずは、基本的な質問です。

「この契約の期間はいつからいつまでですか?」
この質問により、契約期間をすぐに確認できます。

契約書の中では、契約期間が第何条かに書かれていることが多いですが、自分で探すと少し手間です。

NotebookLMに聞けば、該当する内容をもとに答えてくれます。

次に、解約条件を聞いてみます。
「この契約は途中で解約できますか?」

すると、契約書の中にある解約に関する条文をもとに、途中解約の条件を確認できます。

たとえば、
「14日前までに通知すれば解約できる」
という内容が書かれていれば、その点を説明してくれます。

さらに、支払い条件についても質問できます。
「報酬はいつ支払われますか?」
「支払いが発生する条件は何ですか?」

こう聞くことで、報酬の発生タイミングや支払い時期を確認できます。

特に業務委託契約では、ここはとても重要です。
納品した時点で報酬が発生するのか。
検収が終わってからなのか。
翌月末払いなのか。

こうした違いは、実務ではかなり大きいです。

また、著作権についても確認できます。
「納品した記事の著作権は誰のものになりますか?」

この質問によって、作成した文章の権利がどちらに帰属するのかを確認できます。

たとえば、
「報酬の支払い完了後に依頼者へ移転する」
という内容であれば、支払い前と支払い後で扱いが変わる可能性があります。

このように、NotebookLMを使うと、契約書の気になる部分をピンポイントで確認できます。

ただ読むだけでは見落としそうな部分も、質問することで気づきやすくなります。

さらに便利なのは、質問を深掘りできるところです。
たとえば、
「この契約書で受託者が注意すべき点を3つ挙げてください」
と聞けば、自分が気をつけるべきポイントを整理できます。

逆に、
「依頼者側にとって重要な点を教えてください」
と聞けば、相手側の視点でも確認できます。

契約書は、どちらの立場で読むかによって重要なポイントが変わります。

NotebookLMを使えば、その視点の切り替えもしやすくなります。

まとめ:NotebookLMで契約書確認のハードルを下げる

契約書は大事です。
しかし、読むのは面倒です。

文章が難しく、どこを確認すればいいのかわかりにくいことも多いです。
そんなときにNotebookLMを使うと、契約書の内容を質問しながら確認できます。

契約期間、支払い条件、解約条件、著作権、秘密保持など、重要なポイントを一つずつ聞いていけるのが便利です。

特に、契約書に慣れていない人にとっては、最初の理解を助けてくれるツールになります。

もちろん、NotebookLMの回答が常に完全に正しいとは限りません。

重要な契約や金額の大きい契約では、弁護士や専門家に確認することも大切です。

ただし、専門家に相談する前の準備として、
「どこがわからないのか」
「どこが不安なのか」
「何を質問すべきなのか」
を整理するには、とても役立ちます。

契約書をいきなり全部読もうとすると、どうしても気が重くなります。
でも、NotebookLMに読み込ませて質問する形にすれば、確認作業のハードルはかなり下がります。

これからは、契約書を読むときに、
「まずAIに聞いて、全体像をつかむ」
という使い方が広がっていくでしょう。

追記 : 社内の資料も読み込ませることができる

NotebookLMが便利なのは、契約書だけではありません。
社内で使っている重要な資料を読み込ませて、内容を確認する使い方もできます。

たとえば、社内マニュアル、業務手順書、研修資料、会議資料、商品説明資料、顧客対応マニュアルなどです。

こうした資料は、必要なときに限って「どこに書いてあったかな」と探すのが大変です。

フォルダの中にPDFやWordファイルがたくさんあり、ファイル名を見ても中身がすぐにわからないこともあります。

そんなとき、NotebookLMに資料を読み込ませておけば、資料の内容について質問できます。

※冒頭にも書きましたが、超重要機密書類なんかはアップしない方がよろしいです。そういった超機密書類は社内専用サーバでRAGシステムとかで利用しましょう。

さて話は戻って、
NotebookLMには、たとえば、
「この資料の重要ポイントをまとめてください」
「新人が最初に覚えるべき内容は何ですか?」
「顧客対応で注意すべき点を教えてください」
「このマニュアルの手順を簡単に説明してください」
といった聞き方ができます。

これにより、資料を最初から最後まで読み直さなくても、必要な情報にたどり着きやすくなります。

特に社内資料は、一度作ったあとに何度も参照されることが多いです。

しかし、ページ数が多かったり、専門用語が多かったりすると、読むだけで時間がかかります。

NotebookLMを使えば、資料を「読むもの」から「質問できるもの」に変えられます。

これはかなり大きな変化です。

また、複数の資料を読み込ませておけば、関連する内容をまとめて確認することもできます。

たとえば、営業マニュアルと商品説明資料を読み込ませて、
「この商品の説明で営業担当が特に注意すべき点は?」
と質問すれば、資料を横断して内容を整理しやすくなります。

NotebookLMは、資料を読む負担を減らし、必要な情報を見つけやすくする強力な補助ツールです。

契約書だけでなく、社内資料の確認や業務理解にも活用できれば、日々の作業効率を大きく上げることができるでしょう。


****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

クオンツ投資研究 日米業種リードラグ戦略を実装してみました

********

※LINE対応チャットボット版の
「LINEチャットボット屋」
いろんなチャットボットがあります。
ぜひ、ご覧ください!

***************

***************

下記の論文に興味があったので、pythonコードに落とし込んでみました。
「部分空間正則化付き主成分分析を用いた日米業種リードラグ投資戦略」

私自身は投資はしないのですが、クオンツ投資・分析は若い頃から興味があり、いろいろ実装していました。

昨今のLLMの精度が高まったこともあり、さらにクオンツ分析がしやすくなったので重宝しています。

今回はひょんなことから、上記の論文を知ったので、コードに落としての実験を試みた次第です。

コード実行時の結果の動画はこちら↓↓↓

プロジェクト 日米業種リードラグ戦略結果表示

論文のポイント PCA_SUBとは何か

今回試したのは、米国市場の業種別の動きが、日本市場の翌営業日にどのように波及するかを利用する投資戦略です。

ベースにしたのは、「部分空間正則化付きPCA」を使った日米業種リードラグ投資戦略の論文です。

題名はお固いのですが、要は米国で勝った業種銘柄は日本でも勝つかもねっていう理論です。

この手法の中核にあるのがPCA_SUBです。
PCAは主成分分析のことで、多数の業種の値動きの中から共通する大きな流れを取り出す方法です。

ただ、通常のPCAはその時々のデータに引っ張られやすく、相場環境によっては不安定になりやすいという弱点があります。

そこでこの論文では、単なるPCAではなく、あらかじめ意味のある構造を少し与えたうえでPCAを行うという工夫を入れています。

これが「部分空間正則化付きPCA」です。
具体的には、グローバル要因、米国と日本のスプレッド要因、シクリカル業種とディフェンシブ業種の差といった方向を事前に与え、それに寄せながら主成分を推定していきます。

この考え方により、単なるノイズではなく、相場全体に共通する構造を安定的に取り出しやすくなります。
論文でも、通常のPCAや単純モメンタムと比べて、PCA_SUBのほうが高い成績を示していました。

なぜ米国市場の終値が日本市場の翌日に効くのか

この戦略の面白いところは、市場の時間差を利用している点です。

米国市場は日本市場より先に閉まります。
つまり、日本の投資家は朝の時点で、前夜の米国市場で起きた業種別の動きを確認できます。

その情報が、日本市場の寄り付きから引けまでの間に反映されるのではないか、というのが基本的な発想です。

今回の戦略では、米国業種ETFの当日Close-to-Closeリターンを入力として使い、日本業種ETFの翌営業日のOpen-to-Closeリターンを予測します。

言い換えると、前夜の米国業種の強弱を見て、翌日の日本業種の日中の動きを取りにいくという設計です。

この構造はかなり実践的です。
なぜなら、米国の終値は日本の朝にはすでに確定しているからです。

朝の段階で「今日どの業種を強気で見るか、どの業種を弱気で見るか」を決められるため、当日の日中戦略として運用しやすいです。

再現コードの工夫  朝候補と夕方収支を分ける

論文のロジックをColabで再現するにあたって、特に工夫したのは朝に候補を出す処理と、引け後に収支を確認する処理を分けたことです。

朝のセルでは、前営業日までの確定データを使って、その日のロング候補とショート候補を出します。

ここで表示されるのは、たとえば「エネルギー資源」「商社・卸売」「電機・精密」などの強い業種と、「小売」「食品」「医薬品」などの弱い業種です。

一方で、収支の確認は引け後でないと正確にできません。
なぜなら、この戦略は寄り付きで入って引けで決済するため、引値が確定していない昼間に回すと、途中の価格で損益を見てしまうからです。

そこで、収支確認用のセルは別に用意し、引け後にその日の寄値・引値を使って損益を計算するようにしました。

これによって、朝は候補確認、夕方は結果確認という流れが明確になり、運用しやすくなりました。

実運用で見えた課題. セッション切れと候補保存

実際に回してみてわかったのは、Colab特有の問題としてセッション切れがあることです。

朝に候補を出しても、夕方にもう一度Colabを開くとセッションが切れていて、変数が消えていることがあります。

この状態で本体セルをもう一度回すと、朝の候補ではなく、その時点の再計算候補で上書きされる可能性があります。

これを防ぐために、朝候補をCSVとしてGoogle Driveに保存するようにしました。
朝に出たロング候補・ショート候補・全順位をCSV保存しておけば、夕方はそのCSVを読み込むだけで、朝の候補を固定したまま収支計算ができます。

この仕組みによって、「朝に出した候補」と「夕方に確認する収支結果」をきちんと一致させられるようになりました。

理屈の再現だけでなく、実際に日々の運用で使いやすい形に近づいたと思います。

※ちなみに今回作ったコードはGPUを使わないCPUで処理できるため、通常のマイPCで実行可能です。
なので、Pythonの実行環境さえあれば、こういったコラボ特有の処理は不要になります。

今回の検証で見えた実用性と今後の改善点

今回の検証では、PCA_SUBは単純モメンタムや通常のPCAよりも良い結果を出しました。

特に、リスク対比の効率やドローダウンの面で優位性が見えたのは大きかったです。

また、日によっては、景気敏感業種を上位に、ディフェンシブ業種を下位に出すなど、相場の流れとかなり整合的な候補が出ることもありました。

この点からも、PCA_SUBは単なる理論上のモデルではなく、実際の市場の強弱をある程度うまく捉えているように感じました。

ただし課題もあります。
まず、ショート側は実際の証券会社で売建可能かどうかという制約があります。
理論上はロングショートで成り立つ戦略でも、現実には毎日完全に同じ形で執行できるとは限りません。

さらに、データ更新タイミングや、当日データの未確定問題もあります。
そのため、朝候補の保存と引け後の確定収支確認をきちんと分ける運用が重要になります。

今後の改善点としては、地政学リスクのような仕組みを入れることが考えられます。

今回の再現を通じて感じたのは、論文のアイデアそのものが面白いだけでなく、そこから実務で使えるワークフローに落とし込む過程にもかなり意味があるということでした。

朝に候補を確認し、夕方に結果を振り返る。この流れを整えることで、研究と実践の距離がぐっと縮まったように思います。


実際に直近で仮想運用してみての勝敗

今回実際に直近での仮想運用してみての勝敗ですが、図にあるように思ったようには勝てないです。
(ここでの仮想運用とは、実際に現金で投資せず、もし1日10万円を仮に投資した想定の場合、どれほどのリターンがあるかを算出したものです)

過去のデータでは、2024年までの一年間ごとの勝敗は20%以上のリターンがあります。(2025年は10%ちょいだったかな。後で確認してみます)

しかし、今年2026年の1月から3月までのデータでは毎月損失のが多いです。

直近の勝敗の図でも結構負けてます。

この戦略は多くの人が実行すると、当初は上昇するのですが、やがて寄り付きの際にはすでに価格の中に織り込まれるとの見立てです。

過去は勝てたけど、時すでに遅しなのか。
今後も引き続き仮想運用してみます。

結果はまたSNSなどに載せますので、興味のある方はフォローしておいてください。(週単位、隔週単位でのアップか検討中です)


コードの公開について

もともと研究用途で実装したので、コード公開してもいいのですが、私が実装したものが銘柄が出るやつで、これだと、なんでも株式相場の助言なんちゃらにひっかかる可能性が0ではないらしいので、やめておきます。

銘柄出ない版なら公開可らしいのですが、コード修正が面倒でやめておきます。
(グレーゾーンは行かない主義ですので、あしからずです)


****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

小型SVLMがどんなもんか実験してみた

********

※LINE対応チャットボット版の
「LINEチャットボット屋」
いろんなチャットボットがあります。
ぜひ、ご覧ください!

***************

***************

スマホで動く小型SVLMは現実的なのか

ここ最近、AIの話題の中でよく見かけるようになったのが、「エッジデバイスで動く小型のマルチモーダルAI」です。

特に、防衛や産業用途の記事では、ドローンや携帯端末のような現場の機器で、小型の視覚言語モデル、いわゆるSVLMを動かし、その場で状況認識や報告を行うという構想が語られることが増えてきました。

たしかに考えてみると、現場で撮影した画像や動画をその場で簡単に理解し、短い報告文に変換できるAIがあれば便利です。

通信が不安定な場所でも最低限の認識ができ、そこから上位システムへ情報を渡せるからです。

では実際に、スマホのような比較的限られた計算資源の上で、そうした小型SVLMはどこまで現実的なのでしょうか。
今回は、その感触をつかむために試験的な実験を行ってみました。

小型SVLMとは何か、なぜ注目されているのか

SVLMは、画像や動画とテキストをまとめて扱えるマルチモーダルAIの中でも、比較的小さく、軽量化を意識したモデルのことです。

大規模なVLMやLLMがクラウド上で強力な推論を行うのに対し、小型SVLMはスマホやドローン、携帯端末などのエッジ側で動かすことを視野に入れています。

この小型SVLMが注目される理由ははっきりしています。
現場では、すべてのデータを毎回クラウドに送って解析するとは限らないからです。

通信の遅延、接続不良、セキュリティ上の制約などを考えると、まず端末側で「何が見えているか」を簡潔に把握し、必要な情報だけを上位へ渡す仕組みのほうが実用的な場面が多いのです。

ただし、ここで誤解してはいけないのは、小型SVLMは「何でも考えて判断する万能AI」ではないという点です。

むしろ現実的な役割は、「見て、短く説明する」「異常候補を挙げる」「報告文のたたき台を作る」といった一次処理に近いものだと考えられます。

Qwen系モデルで動画理解を試してみた

今回の実験では、Qwen系のマルチモーダルモデルをGoogle Colab上で動かし、短い動画を読み込ませて、その内容を説明させるテストを行いました。

使ったのは3Bクラスと7Bクラスのモデルです。

Qwen2.5-VL-7B-Instruct
Qwen2.5-VL-3B-Instruct

実験の狙いは、現時点の比較的小型なマルチモーダルモデルが、動画をどこまで理解し、どの程度自然な説明や推測ができるのかを見ることにありました。

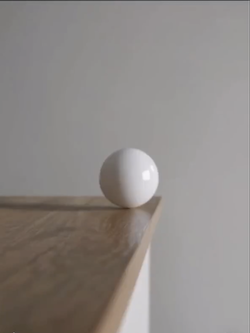
入力したのは、白い球体がテーブルの端付近に置かれている短い動画です。


人間が見ると、球体の位置関係や動きの方向、落ちそうかどうか、といった点に自然と注意が向きます。

そこで、まずは「この動画で何が起きているか」といった基本的な説明をさせ、次に「この先どうなると思うか」といった続きを推測させる質問を投げました。

この種の実験で重要なのは、単に答えが流暢かどうかではありません。
本当に映像の内容を見て答えているのか、それとも一般論で埋めているのかを見分ける必要があります。

そのため、今回の実験では、シーン説明だけでなく、位置変化や未来予測のような少し難しい問いも加えてみました。

3Bと7Bを比べて見えた違い

実際に試してみると、3Bと7Bではかなり違いがありました。

まず、7Bのほうが全体として説明文が自然で、場面のまとまり方も良かったです。

白い球体、木のテーブル、端にある状態、といった特徴を比較的きれいに拾ってくれました。

少なくとも「何が映っているか」をざっくり説明させる用途では、7Bのほうが一段上だと感じました。

一方で、未来予測や物理的な推測になると、7Bでもまだ弱さが見えました。

たとえば「このあとどうなるか」と聞くと、ボールが落ちるかもしれない、止まるかもしれない、転がるかもしれない、といった一般論の候補を並べる傾向がありました。

これは動画を厳密に解析して未来を読んでいるというより、「テーブルの端にあるボールなら、こういう可能性がある」と常識的に補っている印象です。

つまり、7Bは3Bよりも動画の雰囲気理解や説明力は高いものの、物理予測まで高精度にできるわけではありませんでした。

この違いはかなり重要で、マルチモーダルAIに何を期待するかを考えるうえで参考になります。

見たままを短く説明するのは得意でも、その先の世界の動きを正確に推論するのはまだ別の難しさがある、ということです。

スマホ実装でわかった課題

今回の実験を通して強く感じたのは、3Bでも7Bでも、そのままスマホに載せて快適に使うにはまだ重いということでした。

ColabのGPU上では動いても、スマホで同じように動画を処理し、数秒で応答を返し続けるとなると、発熱、メモリ、バッテリー、応答速度の面でかなり厳しくなります。

特に動画は重いです。
静止画1枚ならまだしも、複数フレームを処理しながらテキストを生成するとなると、見た目のパラメータ数以上に負荷を感じます。

そのため、3Bクラスをそのままスマホに持ち込んで万能に使うというよりは、もっと軽量化した1B前後のVLMに役割を限定して持たせるほうが現実的だと感じました。

ここでいう役割限定とは、「画像を見て1文で説明する」「特定対象の有無を答える」「位置の変化を短く報告する」といったものです。

逆に、「このあと何が起こるか」「なぜそうなるか」「物理的に自然か」といった深い推論は、端末側ではなく、本部側のより大きなLLMやルールベースの仕組みに任せたほうが現実的でしょう。

まとめ  スマホで全部考えるより「見て報告するAI」が現実的

今回の実験を通して見えてきたのは、小型SVLMがスマホでまったく使えないわけではない、ということでした。

むしろ、「何が見えているかを短く報告する」用途なら、かなり筋がいいと感じます。

7Bクラスではシーン説明の質が高く、3Bでも方向性を見るには十分な手応えがありました。

ただし、それは「スマホで全部考えるAI」が現実的だという意味ではありません。

現時点では、スマホ側の小型SVLMは前線の目とメモ係に近い役割が向いています。

画像や動画を見て、対象物や位置変化、異常候補を短くまとめ、その結果を本部の大きなLLMや分析システムへ渡す。
この分業構成のほうが、技術的にも運用面でも自然です。

今回の実験は、そうした未来の一端を確かめるものになりました。

今後は、3Bや7Bの能力をそのまま追うよりも、必要な機能だけをうまく削り、1B前後で実用的に動かす設計がより重要になってくるのかもしれません。

今回使ったPythonコード

* 表示のバグでインテントが崩れています。
下記のコードを使用する場合は、お気に入りのAIにコピペして「インテント直して」と言ってください。


# ============================================
# Qwen2.5-VL-7B-Instruct 動画テスト 1セル版
# ボタン送信対応版
# - mp4を1回アップロード
# - 同じ動画に何回でも質問可能
# - HFアクセストークンはテキストボックス入力
# - 空欄で送信すると終了
# ============================================

!pip -q install git+https://github.com/huggingface/transformers accelerate qwen-vl-utils decord ipywidgets

import os
import gc
import time
import torch
import platform
from google.colab import files
from IPython.display import display, clear_output
import ipywidgets as widgets

# ----------------------------
# GPU確認
# ----------------------------
print("Python:", platform.python_version())
print("PyTorch:", torch.__version__)
print("CUDA available:", torch.cuda.is_available())

if torch.cuda.is_available():
print("GPU:", torch.cuda.get_device_name(0))
!nvidia-smi
else:
raise RuntimeError("GPUが見つかりません。Colabの『ランタイムのタイプを変更』でGPUを選んでください。")

print("\n[注意]")
print("7B版は3B版よりかなり重いです。")
print("T4で厳しい場合は、L4/A100 か 3B版に戻すのがおすすめです。")

# ----------------------------
# HFトークン入力
# ----------------------------
print("\n=== Hugging Face アクセストークン入力 ===")
print("公開モデルなので空欄でも動くことがあります。必要なら入力してください。")

hf_token_widget = widgets.Password(
value='',
placeholder='hf_xxxxxxxxxxxxxxxxx',
description='HF Token:',
layout=widgets.Layout(width='650px')
)
display(hf_token_widget)

confirm_token_btn = widgets.Button(
description="トークン確定",
button_style='info'
)
token_status = widgets.Output()

display(confirm_token_btn, token_status)

state = {
"hf_token": "",
"token_confirmed": False,
"video_path": None,
"history": [],
"ended": False,
}

def on_confirm_token_clicked(b):
with token_status:
clear_output()
state["hf_token"] = hf_token_widget.value.strip()
if state["hf_token"]:
os.environ["HUGGINGFACE_HUB_TOKEN"] = state["hf_token"]
print("HFトークンをセットしました。")
else:
print("HFトークン未入力のまま進めます。")
state["token_confirmed"] = True

confirm_token_btn.on_click(on_confirm_token_clicked)

print("\n上の『トークン確定』ボタンを押してから次へ進んでください。")

# ----------------------------
# モデル読み込み
# ----------------------------
from transformers import Qwen2_5_VLForConditionalGeneration, AutoProcessor
from qwen_vl_utils import process_vision_info

MODEL_NAME = "Qwen/Qwen2.5-VL-7B-Instruct"

dtype = torch.float16
if torch.cuda.is_available():
major, minor = torch.cuda.get_device_capability(0)
if major >= 8:
dtype = torch.bfloat16

print(f"\n=== モデル読み込み開始: {MODEL_NAME} ===")
print("dtype:", dtype)

hf_token = hf_token_widget.value.strip()

model_kwargs = {
"torch_dtype": dtype,
"device_map": "auto",
}
processor_kwargs = {}

if hf_token:
model_kwargs["token"] = hf_token
processor_kwargs["token"] = hf_token

model = Qwen2_5_VLForConditionalGeneration.from_pretrained(
MODEL_NAME,
**model_kwargs
)
processor = AutoProcessor.from_pretrained(
MODEL_NAME,
**processor_kwargs
)

print("モデル読み込み完了")

# ----------------------------
# mp4アップロード
# ----------------------------
print("\n=== mp4アップロード ===")
uploaded = files.upload()

video_path = None
for fn in uploaded.keys():
if fn.lower().endswith(".mp4"):
video_path = fn
break

if video_path is None:
raise ValueError("mp4ファイルが見つかりません。短い mp4 を1本アップロードしてください。")

state["video_path"] = video_path

print("動画ファイル:", video_path)
print("ファイルサイズ(MB):", round(os.path.getsize(video_path) / 1024 / 1024, 2))

# ----------------------------
# 推論関数
# ----------------------------
def ask_video(video_path, user_prompt, max_new_tokens=256, fps=1.0, max_pixels=360*420):
# 7Bは重いので fps と max_pixels を少し控えめにして負荷を下げる
messages = [
{
"role": "user",
"content": [
{
"type": "video",
"video": f"file://{os.path.abspath(video_path)}",
"fps": fps,
"max_pixels": max_pixels,
},
{
"type": "text",
"text": user_prompt
}
]
}
]

text = processor.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True
)

image_inputs, video_inputs = process_vision_info(messages)

inputs = processor(
text=[text],
images=image_inputs,
videos=video_inputs,
padding=True,
return_tensors="pt"
)

for k, v in inputs.items():
if hasattr(v, "to"):
inputs[k] = v.to(model.device)

start = time.time()
with torch.no_grad():
generated_ids = model.generate(
**inputs,
max_new_tokens=max_new_tokens,
do_sample=False
)
end = time.time()

generated_ids_trimmed = [
out_ids[len(in_ids):]
for in_ids, out_ids in zip(inputs["input_ids"], generated_ids)
]

output_text = processor.batch_decode(
generated_ids_trimmed,
skip_special_tokens=True,
clean_up_tokenization_spaces=False
)[0]

elapsed = end - start
return output_text, elapsed

# ----------------------------
# UI部品
# ----------------------------
print("\n=== 質問UI ===")
print("質問を入力して『送信』を押してください。")
print("空欄のまま『送信』を押すと終了します。")

prompt_widget = widgets.Textarea(
value="この動画で何が起きているか、2〜3文で日本語で説明してください。",
placeholder="ここに質問を書く。空欄で送信すると終了。",
description="Prompt:",
layout=widgets.Layout(width='900px', height='140px')
)

max_tokens_widget = widgets.IntText(
value=180,
description='MaxTokens:',
layout=widgets.Layout(width='260px')
)

fps_widget = widgets.FloatText(
value=1.0,
description='FPS:',
layout=widgets.Layout(width='220px')
)

max_pixels_widget = widgets.IntText(
value=360 * 420,
description='MaxPixels:',
layout=widgets.Layout(width='260px')
)

send_button = widgets.Button(
description="送信",
button_style='success',
icon='paper-plane'
)

end_button = widgets.Button(
description="強制終了",
button_style='warning',
icon='stop'
)

status_output = widgets.Output()
answer_output = widgets.Output()
history_output = widgets.Output()

display(prompt_widget)
display(widgets.HBox([max_tokens_widget, fps_widget, max_pixels_widget]))
display(widgets.HBox([send_button, end_button]))
display(status_output)
display(answer_output)
display(history_output)

# ----------------------------
# ボタン動作
# ----------------------------
def redraw_history():
with history_output:
clear_output()
print("=== 質問履歴 ===")
if not state["history"]:
print("まだ質問はありません。")
return

for i, item in enumerate(state["history"], 1):
print(f"\n--- {i}回目 ---")
print("Prompt:", item["prompt"])
print("Output:", item["output"])
print("推論時間:", f'{item["elapsed"]:.2f} 秒')
print("fps:", item["fps"], "| max_pixels:", item["max_pixels"])

def on_send_clicked(b):
if state["ended"]:
with status_output:
clear_output()
print("すでに終了しています。")
return

user_prompt = prompt_widget.value.strip()
max_new_tokens = int(max_tokens_widget.value)
fps = float(fps_widget.value)
max_pixels = int(max_pixels_widget.value)

if user_prompt == "":
state["ended"] = True
send_button.disabled = True
prompt_widget.disabled = True
max_tokens_widget.disabled = True
fps_widget.disabled = True
max_pixels_widget.disabled = True

with status_output:
clear_output()
print("空欄送信を検出しました。終了します。")

with answer_output:
print("\n処理を終了しました。")
return

with status_output:
clear_output()
print("推論中です... 7B版なので少し時間がかかることがあります。")

try:
output_text, elapsed = ask_video(
video_path=state["video_path"],
user_prompt=user_prompt,
max_new_tokens=max_new_tokens,
fps=fps,
max_pixels=max_pixels
)

state["history"].append({
"prompt": user_prompt,
"output": output_text,
"elapsed": elapsed,
"max_new_tokens": max_new_tokens,
"fps": fps,
"max_pixels": max_pixels,
})

with answer_output:
print("\n==============================")
print("Prompt:")
print(user_prompt)
print("------------------------------")
print("Output:")
print(output_text)
print("------------------------------")
print(f"推論時間: {elapsed:.2f} 秒")
if torch.cuda.is_available():
print(f"GPU使用メモリ allocated: {torch.cuda.memory_allocated()/1024**3:.2f} GB")
print(f"GPU使用メモリ reserved : {torch.cuda.memory_reserved()/1024**3:.2f} GB")
print("==============================\n")

with status_output:
clear_output()
print(f"完了しました。質問回数: {len(state['history'])}")

redraw_history()

except Exception as e:
with status_output:
clear_output()
print("エラーが出ました。")
print(str(e))
print("\n対策例:")
print("- fps を 0.5 に下げる")
print("- MaxTokens を 128 に下げる")
print("- MaxPixels を 200*280 くらいに下げる")
print("- もっと短い mp4 にする")
print("- L4 / A100 に変える")

def on_end_clicked(b):
state["ended"] = True
send_button.disabled = True
prompt_widget.disabled = True
max_tokens_widget.disabled = True
fps_widget.disabled = True
max_pixels_widget.disabled = True

with status_output:
clear_output()
print("強制終了しました。")

gc.collect()
if torch.cuda.is_available():
torch.cuda.empty_cache()

send_button.on_click(on_send_clicked)
end_button.on_click(on_end_clicked)

print("\n準備完了。質問を書いて『送信』を押してください。")

****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

***************

GoogleのGemma-2Bを使ってRAGを試してみた

********

※LINE対応チャットボット版の
「LINEチャットボット屋」
いろんなチャットボットがあります。
ぜひ、ご覧ください!

***************

***************

小型モデルを回答&分析に使うメリット

小型の生成AIモデルで、どこまで実用的なことができるのかを試します。

そこで今回は、GoogleのGemma-2Bを使って、RAGの簡単なテストをしてみました。

小型モデルを使う利点は、大型モデルと違って、社内にシステムを置けるので、情報漏洩がしづらいと言うところです

chataGPTなどの大型モデルを使うと、社内の資料をアップロードしないといけないので、情報が外に漏れてしまいます。

こういったことを気にしないで活用できるのが、小型モデルの良いところでしょう。

さて、RAGは外部の資料を検索して、その内容をもとに回答&分析を作る仕組みです。

モデルが元から知っている知識だけで答えるのではなく、自分で資料を参照しながら返答するので、うまく作れれば特定の文書に強いAIを作ることができます。

有名なシステムでわかりやすいのはGoogleの出しているnotebook LMです。
ただしあちらはサーバ上で動いているので、やはり社内などの文章をアップロードすると、情報が漏れるって言う、いいんだか悪いんだかが起きますね。

そこで今回は、大がかりな本番システムを作らず、まずはGoogle Colab上で動くシンプルな構成で、Gemma-2Bのような比較的小さなモデルでもRAGらしい動きができるのかを確かめてみました。

そもそもRAGとは何か

RAGは、日本語では「検索拡張生成」などと呼ばれます。

ざっくり言えば、まず質問に関連する文章を資料の中から探し、その検索結果を生成AIに渡して回答や分析をさせる仕組みです。

普通のチャットAIは、学習済みの知識をもとに答えます。
しかしRAGを使うと、手元のテキストファイルや社内文書、マニュアル、議事録、取引先データなどを参照しながら答えさせることができます。

つまり、モデル自体を追加学習しなくても、ある程度その場で知識を補えるわけです。

この仕組みの面白いところは、モデルのサイズがそれほど大きくなくても、参照資料がしっかりしていれば役立つ回答&分析ができることです。

逆に言えば、モデルそのものの性能だけでなく、資料の分け方や検索精度がかなり重要になります。
今回のテストでも、まさにそこがポイントになりました。

今回の環境と使用した諸々

今回の実験環境はGoogle Colabです。
ローカル環境を整えなくても始めやすく、ちょっとしたRAGの試作にはかなり便利です。

役割としては、Gemma-2Bが回答生成を担当し、SentenceTransformerがテキストの埋め込みを作り、FAISSがベクトル検索を担当します。

Gradioは簡単な操作画面を作るために使いました。
これにより、Hugging Faceのトークンを入力してモデルを初期化し、テキストファイルをアップロードし、質問を入力して回答を得る、という一連の流れをブラウザ上で試せるようにしました。

最初はとにかく最小構成で動かすことを優先し、1セルで完結するコードにしていました。

こういう形は試行錯誤しやすい反面、後から見ると雑な実装になりやすく、精度面でも改善の余地が多いですね。

実装してみてつまずいたポイント

実際に組んでみると、最初から順調に進んだわけではありません。まず単純な構文ミスがありました。

関数定義の引数のところに余計な文字が混ざっていて、それだけでエラーになります。
こういうミスは地味ですが、Colabで一気に書いていると意外と起きやすいです。

ファイル読み込みや空入力に対する例外処理も必要でした。
こうした部分をちゃんと整えるだけでも、実験コードとしてかなり扱いやすくなります。

RAGは検索や生成の精度に目が行きがちですが、その前にまずシステムが落ちずに動かすことだと、あらためて感じました。

なぜ最初は精度があまり出なかったのか

動くようになってから試してみると、精度はあまり高くありませんでした。

質問に対して少しずれた回答をしたり、資料に書かれていないことをうまく拾えなかったりします。

最初はGemma-2Bという小型モデルの限界かなと思ったのですが、見直してみると、原因はモデルだけではありませんでした。

一番大きかったのは、テキストの分割方法です。

最初は単純に文字数で区切っていたので、文の途中で分かれたり、見出しと本文が離れたりして、検索しにくい断片が大量にできていました。
これでは、検索で拾う文章の質が下がってしまいます。

もう一つは埋め込みモデルです。最初は英語寄りの埋め込みモデルを使っていたため、日本語のテキストを扱うには相性がいまひとつでした。

さらに、検索時に取る件数が少なすぎると、たまたま外したときにそのまま精度低下につながります。

つまり、生成モデルの前段階である検索部分に改善余地がかなりあったわけです。

チャンク分割や検索方法を見直してみた

そこで、精度改善版ではまずチャンク分割を見直しました。
文字数で機械的に切るのではなく、段落ベースでまとめ、長すぎる段落だけ追加で分割するようにします。

これだけでも、意味のまとまりが保たれやすくなり、検索の質が上がります。
さらに overlap を入れて、前後の文脈が多少つながるようにしました。

埋め込みモデルも、多言語対応の intfloat/multilingual-e5-base に変更。
日本語の資料を扱うなら、こうした多言語系のモデルのほうが安定感があります。

加えて、E5系の推奨に合わせて、文書側には passage:、質問側には query: という接頭辞を付けて埋め込みを作るようにしました。

検索部分では、FAISSのIndexFlatL2からIndexFlatIPに変更。
埋め込みを正規化して使うなら、内積ベースのほうが相性が良いケースがあります。

また、検索件数も top_k=3 から top_k=5 に増やしました。これにより、関連文脈を取りこぼしにくくなりました。

さらに、デバッグのために「実際に検索で拾った文脈をそのまま表示する機能」も付けました。これがかなり便利で、精度が悪い原因が検索側なのか、生成側なのかを切り分けやすくなりました。

小型モデルでRAGを試す面白さ

今回試してみて感じたのは、Gemma-2Bのような小型モデルでも、RAGの基本構成を理解したり、簡単な実験をしたりするには十分面白いということです。

もちろん、大型モデルに比べると読解力や回答の安定性には差がありますし、複雑な質問では限界も見えます。

ただし、RAGではモデル本体だけでなく、資料の整え方、チャンク分割、埋め込みモデル、検索方法などが全体の精度に大きく効きます。

つまり、小型モデルだから駄目と決めつけるのではなく、周辺設計を丁寧に詰めることでかなり改善できる余地があります。

今回のテストは、まさにそのことを実感する機会になりました。
最初は「何となく動いた」段階でしたが、検索部分をきちんと見直すことで、回答の納得感がかなり変わってきます。

RAGは単なる生成AIの応用ではなく、検索設計まで含めた総合戦だとよく分かります。

もしこれから試すなら、まずは小さく作って動かし、検索結果の確認機能を入れながら、少しずつ精度を詰めていくのがおすすめです。

Gemma-2Bを使った今回の実験は、その第一歩としてかなり面白い実験でした。

必要以上に大きな構成にせず、まずは手軽に試してみる。それだけでも、RAGの勘所はかなりつかめると思います。

今回使用したコード

*表示のバグでインデントが崩れています。
コピーしてお気に入りのAIに直してもらってください。


# -*- coding: utf-8 -*-
"""
Gemma-2B RAG System (All-in-One Cell) - Accuracy Improved Version
Google Colab 用
"""

# ==========================================
# 1. ライブラリのインストール
# ==========================================
!pip install -q transformers sentence-transformers faiss-cpu gradio accelerate

# ==========================================
# 2. インポート
# ==========================================
import os
import re
import faiss
import gradio as gr
import numpy as np
import torch

from transformers import AutoTokenizer, AutoModelForCausalLM
from sentence_transformers import SentenceTransformer

# ==========================================
# 3. グローバル変数
# ==========================================
model = None
tokenizer = None
embedder = None
index = None
chunked_texts = []

# ==========================================
# 4. ユーティリティ
# ==========================================
def get_torch_dtype():
if torch.cuda.is_available():
return torch.float16
return torch.float32

def get_model_input_device():
try:
return next(model.parameters()).device
except Exception:
return torch.device("cuda" if torch.cuda.is_available() else "cpu")

def clean_text(text):
if not text:
return ""
text = text.replace("\r\n", "\n").replace("\r", "\n")
text = re.sub(r"\n{3,}", "\n\n", text)
text = re.sub(r"[ \t]+", " ", text)
return text.strip()

# ==========================================
# 5. システム初期化・リセット
# ==========================================
def initialize_system(hf_token):
global model, tokenizer, embedder, index, chunked_texts

index = None
chunked_texts = []

try:
model_id = "google/gemma-2b-it"

if tokenizer is None:
tokenizer = AutoTokenizer.from_pretrained(
model_id,
token=hf_token if hf_token else None
)

if model is None:
dtype = get_torch_dtype()
model = AutoModelForCausalLM.from_pretrained(
model_id,
token=hf_token if hf_token else None,
device_map="auto",
torch_dtype=dtype
)
model.eval()

# 精度重視で small → base に変更
if embedder is None:
embedder = SentenceTransformer("intfloat/multilingual-e5-base")

dimension = embedder.get_sentence_embedding_dimension()

# normalize_embeddings=True と相性のよい Inner Product 検索
index = faiss.IndexFlatIP(dimension)

return "システム初期化完了(データはリセットされました。新しいファイルをアップロードしてください)"

except Exception as e:
return f"初期化エラー: {str(e)}"

# ==========================================
# 6. 精度改善版テキスト分割
# - 段落ベース
# - 長すぎる段落のみ追加分割
# ==========================================
def split_text(text, chunk_size=500, overlap=100):
text = clean_text(text)
if not text:
return []

paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]
chunks = []
current = ""

for para in paragraphs:
# 今の current に追加できるなら追加
if len(current) + len(para) + 2 <= chunk_size: current += ("\n\n" + para) if current else para else: if current: chunks.append(current) # 段落自体が長すぎるならスライド分割 if len(para) > chunk_size:
start = 0
while start < len(para): end = min(start + chunk_size, len(para)) chunk = para[start:end].strip() if chunk: chunks.append(chunk) if end >= len(para):
break
start += chunk_size - overlap
current = ""
else:
current = para

if current:
chunks.append(current)

# 空要素除去
chunks = [c.strip() for c in chunks if c and c.strip()]
return chunks

# ==========================================
# 7. ファイル読み込み・保存
# ==========================================
def process_and_store_file(file_obj):
global index, chunked_texts, embedder

if index is None:
return "先に [Initialize / Reset System] ボタンを押してください。"

if file_obj is None:
return "ファイルが選択されていません。"

try:
file_path = getattr(file_obj, "name", None)
if file_path is None:
file_path = file_obj

with open(file_path, "r", encoding="utf-8") as f:
text = f.read()

except UnicodeDecodeError:
return "エラー: ファイルの文字コードがUTF-8ではありません。"
except Exception as e:
return f"ファイル読み込みエラー: {str(e)}"

text = clean_text(text)
if not text:
return "エラー: ファイルの中身が空です。"

chunks = split_text(text, chunk_size=500, overlap=100)

if not chunks:
return "テキストを分割できませんでした。ファイル内容を確認してください。"

try:
passages = [f"passage: {c}" for c in chunks]
embeddings = embedder.encode(
passages,
convert_to_numpy=True,
normalize_embeddings=True,
show_progress_bar=False
).astype("float32")

index.add(embeddings)
chunked_texts.extend(chunks)

except Exception as e:
return f"埋め込み保存エラー: {str(e)}"

return (
f"完了: {os.path.basename(file_path)} から "
f"{len(chunks)} チャンクの情報を記憶しました。"
)

# ==========================================
# 8. 検索
# - top_k を 5 に増量
# - デバッグ用にスコア付き検索も返せるように
# ==========================================
def retrieve_context(query, top_k=5, return_debug=False):
global index, chunked_texts, embedder

if index is None or index.ntotal == 0:
return "" if not return_debug else []

if not query or not query.strip():
return "" if not return_debug else []

try:
query_embedding = embedder.encode(
[f"query: 次の質問に関連する箇所を資料から探してください。質問: {query}"],
convert_to_numpy=True,
normalize_embeddings=True,
show_progress_bar=False
).astype("float32")

k = min(top_k, index.ntotal)
scores, indices = index.search(query_embedding, k)

results = []
for score, idx in zip(scores[0], indices[0]):
if idx != -1 and 0 <= idx < len(chunked_texts):
results.append({
"score": float(score),
"text": chunked_texts[idx]
})

if return_debug:
return results

return "\n---\n".join([r["text"] for r in results])

except Exception:
return "" if not return_debug else []

# ==========================================
# 9. 検索結果確認用
# ==========================================
def preview_retrieved_context(query):
if model is None or tokenizer is None:
return "エラー: システムが初期化されていません。"

if not query or not query.strip():
return "質問を入力してください。"

results = retrieve_context(query, top_k=5, return_debug=True)

if not results:
return "関連する情報が見つかりませんでした。"

lines = []
for i, item in enumerate(results, start=1):
lines.append(f"[候補 {i}] score={item['score']:.4f}\n{item['text']}")

return "\n\n==============================\n\n".join(lines)

# ==========================================
# 10. 回答生成
# ==========================================
def generate_answer(query):
global model, tokenizer

if model is None or tokenizer is None:
return "エラー: システムが初期化されていません。"

if not query or not query.strip():
return "質問を入力してください。"

context = retrieve_context(query, top_k=5)

if not context:
return "アップロードされた資料の中に、関連する情報が見つかりませんでした。"

prompt = f"""あなたは資料の内容に忠実なアシスタントです。
以下の[参照資料]だけを根拠に回答してください。
資料にないことは「資料には書かれていません」と答えてください。
推測や想像で補完してはいけません。
回答は簡潔かつ具体的に述べ、必要なら箇条書きで示してください。

[参照資料]
{context}

[質問]
{query}

[回答]
"""

try:
input_device = get_model_input_device()
inputs = tokenizer(
prompt,
return_tensors="pt",
truncation=True,
max_length=2048
)
inputs = {k: v.to(input_device) for k, v in inputs.items()}

with torch.no_grad():
outputs = model.generate(
**inputs,
max_new_tokens=256,
do_sample=False
)

generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
answer = generated_text[len(prompt):].strip()

if not answer:
return "回答を生成できませんでした。"

return answer

except Exception as e:
return f"回答生成エラー: {str(e)}"

# ==========================================
# 11. UI構築
# ==========================================
with gr.Blocks() as demo:
gr.Markdown("## Gemma-2B RAG System(精度改善版)")

with gr.Group():
gr.Markdown("### 1. 初期化(リセット)")
with gr.Row():
token_input = gr.Textbox(
label="Hugging Face Token",
type="password",
placeholder="hf_..."
)
init_btn = gr.Button("Initialize / Reset System")
init_status = gr.Textbox(label="Status", interactive=False)
init_btn.click(fn=initialize_system, inputs=token_input, outputs=init_status)

gr.Markdown("---")

with gr.Group():
gr.Markdown("### 2. テキストファイルをアップロード")
file_input = gr.File(label="Upload Text File (.txt)", file_types=[".txt"])
upload_status = gr.Textbox(label="Upload Status", interactive=False)
file_input.upload(fn=process_and_store_file, inputs=file_input, outputs=upload_status)

gr.Markdown("---")

with gr.Group():
gr.Markdown("### 3. 質問")
query_input = gr.Textbox(
label="Ask Question",
placeholder="例: この資料の要点は?"
)

with gr.Row():
preview_btn = gr.Button("Preview Retrieved Context")
submit_btn = gr.Button("Submit")

preview_output = gr.Textbox(label="Retrieved Context Preview", lines=14)
answer_output = gr.Textbox(label="Answer", lines=10)

preview_btn.click(fn=preview_retrieved_context, inputs=query_input, outputs=preview_output)
submit_btn.click(fn=generate_answer, inputs=query_input, outputs=answer_output)

demo.launch(debug=True, share=True)

****************

最近のデジタルアート作品を掲載!

X 旧ツイッターもやってます。
https://x.com/ison1232

インスタグラムはこちら
https://www.instagram.com/nanahati555/

**************

PAGE TOP